Como lidar com redirecionamentos via proxy: por que POST vira GET e cabeçalhos desaparecem
Sumário do artigo
- Introdução: a requisição sai como post, mas chega como get – quem é o culpado
- Preparação: ferramentas e acessos
- Conceitos básicos em linguagem simples
- Passo 1: entendendo os quatro códigos – 301 e 302 versus 307 e 308
- Passo 2: o que se perde no redirecionamento – authorization, cabeçalhos personalizados, cookies
- Passo 3: comportamento padrão em diferentes clientes
- Passo 4: controle manual de redirecionamentos – quando é o único caminho certo
- Passo 5: limitando a profundidade e se protegendo contra loops
- Passo 6: redirecionamentos e mudança de ip – por que a cadeia vai para outro proxy
- Passo 7: depuração – como ver toda a cadeia e os códigos etapa por etapa
- Verificação do resultado: checklist
- Erros comuns e soluções
- Recursos adicionais e otimização
- Faq: perguntas frequentes sobre tratamento de redirecionamentos
- Conclusão
Você envia uma requisição usando o método POST com corpo e cabeçalho de autorização, e o que chega ao servidor é um GET vazio, sem nenhum cabeçalho personalizado. Situação familiar? Se você trabalha com proxies e requisições automatizadas, mais cedo ou mais tarde vai se deparar com esse comportamento. Isso não é um bug do seu código nem uma falha do proxy Proxeon. É a mecânica normal dos redirecionamentos HTTP, prevista pela especificação, que você só precisa entender e saber controlar.
Neste guia, vamos analisar por que o método da requisição pode mudar e os cabeçalhos podem sumir ao seguir um redirecionamento. Você vai aprender a diferença entre os códigos 301, 302, 307 e 308, como diferentes clientes HTTP se comportam por padrão, e vai receber exemplos práticos de como desativar os redirecionamentos automáticos e tratá-los manualmente. Tudo com código real, sem enrolação.
Introdução: a requisição sai como POST, mas chega como GET – quem é o culpado
Imagine uma tarefa de engenharia. Você faz uma requisição POST para um endpoint de autenticação via proxy. O servidor responde com um código de redirecionamento e indica um novo endereço. Seu cliente HTTP segue esse endereço automaticamente. Mas ele segue já usando o método GET, sem o corpo da requisição e sem o cabeçalho Authorization. No fim, o servidor de destino recebe outra coisa, e a lógica quebra.
Quem é o culpado? Formalmente, ninguém. Esse comportamento está enraizado na implementação histórica dos códigos 301 e 302. Antigamente, navegadores e bibliotecas quase sempre mudavam o método para GET ao receber esses códigos. Isso virou um padrão de facto e foi consolidado. Depois, para dar aos desenvolvedores a possibilidade de preservar o método e o corpo, foram criados os códigos 307 e 308. Vamos falar deles em detalhes abaixo.
O que você vai conseguir no final
Depois de ler este guia, você vai gerenciar redirecionamentos com confiança em qualquer cliente HTTP popular. Você vai conseguir prever o que acontece com o método e o corpo da requisição. Vai aprender a preservar cabeçalhos críticos durante os redirecionamentos. E vai conseguir depurar cadeias complexas de redirecionamentos que passam por um proxy.
Para quem é este guia
- Para desenvolvedores que escrevem parsers, integrações e automações usando proxies.
- Para engenheiros de QA que testam APIs e fluxos web.
- Para profissionais de DevOps que configuram o proxy de tráfego.
- Para todos que já ficaram se perguntando por que o POST virou GET.
O que você precisa saber antes
Conhecimento básico do protocolo HTTP: o que é método de requisição, cabeçalhos, corpo e código de status da resposta. Saber executar comandos no terminal. É recomendável ter familiaridade mínima com uma das linguagens: Python ou JavaScript. Se faltar algum desses conhecimentos, não se preocupe – vamos explicar os termos-chave de forma simples em uma seção separada.
Quanto tempo vai levar
Para uma leitura atenta e repetição de todos os exemplos, você vai precisar de cerca de 60 minutos. Se você só precisa resolver um problema específico, use o índice e vá direto para a seção necessária.
Preparação: ferramentas e acessos
Antes de trabalhar com os exemplos, prepare seu ambiente de desenvolvimento. Isso leva um tempinho, mas depois tudo flui melhor.
Ferramentas necessárias
- Instale o curl versão 7.88 ou superior. Verifique com o comando
curl --versionno terminal. - Instale o Python versão 3.10 ou superior. Verifique com o comando
python --version. - Instale as bibliotecas Python: execute
pip install requests httpx. - Instale o Node.js versão 20 ou superior, se planeja testar o axios e o fetch. Verifique com o comando
node --version. - Instale o axios com
npm install axiosna pasta de teste do projeto.
Acesso ao proxy
Para praticar, você vai precisar de proxies Proxeon ativos. Prepare os dados de conexão: endereço do servidor, porta, login e senha. Mantenha-os em um lugar seguro. Vamos usá-los nos exemplos de código.
Dica: Nunca guarde o login e a senha do proxy diretamente no código. Use variáveis de ambiente. Por exemplo, no terminal defina export PROXY_URL=http://user:pass@host:port e, no código, leia esse valor do ambiente. Assim você não envia segredos para o repositório por acidente.
Requisitos de sistema
Qualquer computador moderno com Windows 10 ou superior, macOS 12 ou superior ou uma distribuição Linux atual serve. Não há requisitos especiais de hardware: trabalhar com requisições HTTP não sobrecarrega o sistema.
⚠️ Atenção: Se você for testar em um servidor de produção, crie primeiro um branch separado de código ou um script de teste separado. Não experimente a lógica de redirecionamentos diretamente na produção – mudar o comportamento dos redirecionamentos pode quebrar a autenticação e fazer com que as requisições vão para lugares errados.
✅ Verificação: Nesta etapa, você deve conseguir executar com sucesso os comandos de verificação de versão do curl, Python e Node.js, e os dados do proxy Proxeon devem estar salvos na variável de ambiente.
Conceitos básicos em linguagem simples
Para facilitar o que vem a seguir, vamos revisar os termos principais. Mesmo que você já os conheça, não custa nada relembrar.
O que é um redirecionamento
Um redirecionamento é uma resposta do servidor que diz ao cliente: o recurso que você procura não está aqui, vá para outro endereço. O servidor retorna um código de status da família 3xx e o cabeçalho Location com o novo endereço. O cliente lê esse cabeçalho e envia uma nova requisição para lá.
O que é método de requisição e corpo
O método é o tipo de ação. GET pede dados, POST envia dados para o servidor, PUT atualiza, DELETE remove. O corpo da requisição é a carga útil que você envia junto com POST ou PUT. Por exemplo, um JSON com login e senha na autenticação.
O que são cabeçalhos
Cabeçalhos são metadados da requisição. Eles transmitem informações adicionais: formato dos dados (Content-Type), autenticação (Authorization), agente do usuário (User-Agent), seus próprios campos auxiliares. Em um redirecionamento, parte dos cabeçalhos pode ser preservada e parte pode se perder. É isso que geralmente quebra a lógica.
O que é redirecionamento automático
Redirecionamento automático é quando seu cliente HTTP, por conta própria, sem sua participação, segue para o endereço do cabeçalho Location. A maioria dos clientes faz isso por padrão. É prático, mas perigoso: você perde o controle sobre o que acontece com o método, o corpo e os cabeçalhos entre as etapas.
Como o proxy se encaixa nisso
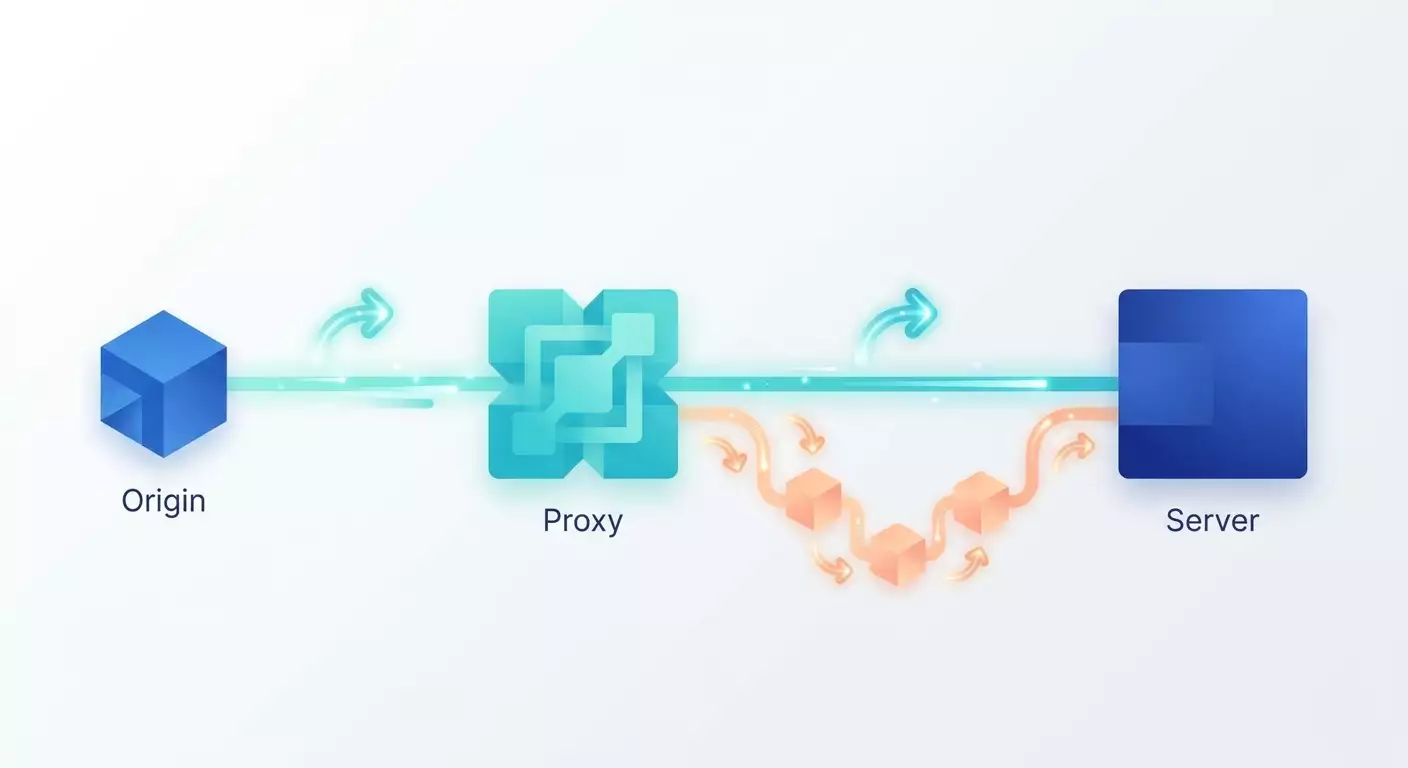
O proxy Proxeon fica entre seu cliente e o servidor de destino. Ele encaminha sua requisição e retorna a resposta. Em um redirecionamento, o proxy apenas repassa o código de status e o cabeçalho Location. A decisão de seguir é do seu cliente. Um detalhe importante: se você usa um pool de proxies com rotação, diferentes etapas da cadeia de redirecionamentos podem passar por IPs diferentes. Vamos voltar a isso mais adiante.
Dica: Lembre-se desta regra simples: o proxy não muda o método da requisição em um redirecionamento. Quem muda o método é o seu cliente HTTP, seguindo as regras de processamento do código de status. Portanto, procure a causa nas configurações do cliente, e não no proxy.
Passo 1: Entendendo os quatro códigos – 301 e 302 versus 307 e 308
Objetivo desta etapa: aprender a identificar com precisão o que acontece com o método e o corpo da requisição ao receber cada um dos quatro códigos de redirecionamento.
Essa é a base de todo o guia. Se você absorver a diferença entre esses códigos, metade dos problemas com redirecionamentos desaparece sozinha.
Código 301 – redirecionamento permanente
Significa que o recurso mudou de endereço permanentemente. Historicamente, ao receber um 301, os clientes mudam o método POST para GET e descartam o corpo da requisição. Formalmente, a especificação não exige isso, mas é o que acontece na prática, e quase todos os clientes fazem isso por compatibilidade reversa.
Código 302 – redirecionamento temporário
Significa que o recurso está temporariamente acessível em outro endereço. O comportamento é semelhante ao 301: na prática, o POST vira GET e o corpo se perde. É o código 302 que geralmente é o culpado da situação descrita na introdução.
Código 307 – redirecionamento temporário preservando o método
Esse código foi criado especificamente para resolver o problema da mudança de método. Com o 307, o cliente é obrigado a preservar o método e o corpo originais. Enviou POST? Vai POST. Enviou corpo? Ele será transmitido adiante. É o equivalente temporário do 302, mas sem surpresas com o método.
Código 308 – redirecionamento permanente preservando o método
O equivalente permanente do 301, mas preservando método e corpo. Enviou POST? Chega POST. É o código mais previsível para redirecionar requisições POST.
Tabela resumo do comportamento
Abaixo está uma descrição textual da tabela para você ter o panorama na cabeça.
- 301: permanente. Na prática, o método POST vira GET. O corpo é descartado. GET continua GET.
- 302: temporário. Na prática, o método POST vira GET. O corpo é descartado. GET continua GET.
- 307: temporário. O método é totalmente preservado. O corpo é preservado. POST continua POST.
- 308: permanente. O método é totalmente preservado. O corpo é preservado. POST continua POST.
⚠️ Atenção: Não confie que todos os servidores seguem a especificação à risca. Alguns sistemas antigos retornam 302 onde logicamente seria necessário 307, esperando que o método seja preservado. Sempre verifique o comportamento real, não apenas o código. Teste em um endpoint real.
Dica: Se você desenvolve seu próprio servidor e quer que requisições POST permaneçam POST após um redirecionamento, use os códigos 307 ou 308. Isso evita surpresas desagradáveis para seus clientes e economiza tempo de depuração.
✅ Verificação: Você consegue, olhando para o código da resposta, dizer imediatamente se o método e o corpo serão preservados. Para 307 e 308 – sim. Para 301 e 302 – na prática, não.
Passo 2: O que se perde no redirecionamento – Authorization, cabeçalhos personalizados, cookies
Objetivo desta etapa: entender quais dados desaparecem em um redirecionamento e por quê, para planejar sua preservação com antecedência.
A mudança de método não é o único problema. Mesmo com os códigos 307 e 308, quando o método é preservado, parte dos cabeçalhos pode sumir. Vamos analisar as três maiores perdas.
Perda do cabeçalho Authorization ao mudar de domínio
Esse é o problema mais comum e mais traiçoeiro. Por motivos de segurança, a maioria dos clientes HTTP remove o cabeçalho Authorization ao redirecionar para outro domínio. A lógica é simples: se você se autentica no site A, seu token secreto não deve ir automaticamente para o site B, para onde você foi redirecionado. Caso contrário, um invasor poderia configurar um redirecionamento e extrair suas credenciais.
O resultado: você envia uma requisição com token correto, o cliente segue o redirecionamento para outro domínio, mas sem o Authorization. O servidor de destino responde que você não está autenticado. Tudo faz sentido, mas não é óbvio.
Dica: Se você realmente precisa enviar a autenticação para outro domínio, faça isso de forma consciente e manual. Desative o redirecionamento automático, verifique para onde exatamente o Location aponta, confirme que é um endereço confiável e só então adicione o cabeçalho Authorization na nova requisição com suas próprias mãos.
Perda de cabeçalhos personalizados
Seus próprios cabeçalhos – por exemplo, campos auxiliares como X-Request-Id ou X-Client-Version – se comportam de maneiras diferentes em cada cliente durante o redirecionamento automático. Algumas bibliotecas os repassam adiante, outras os descartam. Não dá para confiar nisso. Se o cabeçalho for crítico para a lógica, controle seu envio manualmente.
Perda de cookies com flags
Cookies têm flags que restringem seu envio. O flag Secure só permite o envio por conexões seguras. O flag Domain limita os domínios para os quais o cookie é enviado. O flag SameSite regula o envio em transições entre sites. Se o redirecionamento levar você a um domínio ou protocolo que não atende aos flags do cookie, esse cookie simplesmente não será enviado.
Por exemplo, um cookie com o flag Secure não será enviado se o redirecionamento levar a um endereço não seguro. Um cookie com restrição de domínio não irá para um domínio diferente. Esse é um comportamento correto do ponto de vista de segurança, mas precisa ser considerado.
⚠️ Atenção: Nunca tente remover à força os flags de segurança de cookies de terceiros ou enviar Authorization para domínios não confiáveis por conveniência. Esses mecanismos protegem suas credenciais. Contorne-os apenas em infraestrutura que você controla totalmente e com plena compreensão das consequências.
✅ Verificação: Você entende as três classes de perda em um redirecionamento: o cabeçalho Authorization em outro domínio, cabeçalhos personalizados e cookies com flags restritivos. Você sabe que cada um deles só pode ser restaurado com um tratamento manual consciente.
Passo 3: Comportamento padrão em diferentes clientes
Objetivo desta etapa: saber como cada cliente HTTP popular se comporta, para não se surpreender com as diferenças.
A principal armadilha é que o comportamento padrão varia de cliente para cliente. Vamos analisar os cinco mais comuns.
curl
Por padrão, o curl não segue redirecionamentos. Ele simplesmente mostra a resposta com o código 3xx e o cabeçalho Location. Para ativar o redirecionamento automático, você precisa adicionar explicitamente a flag -L. Isso torna o curl muito previsível: você sempre sabe que, sem a flag, não haverá redirecionamentos ocultos.
Exemplo de requisição sem redirecionamento:
curl -i -x $PROXY_URL https://example.com/redirectA flag -i mostra os cabeçalhos da resposta, a flag -x define o proxy. Você verá o código e o Location, mas não haverá redirecionamento.
requests (Python)
A biblioteca requests segue redirecionamentos automaticamente por padrão. Para os códigos 301, 302 e 303, ela muda o método POST para GET. Para 307 e 308, preserva o método. Para desativar o redirecionamento automático, use o parâmetro allow_redirects=False.
httpx (Python)
Fato interessante: o httpx NÃO segue redirecionamentos por padrão, ao contrário do requests. Isso foi feito de forma consciente, para que o desenvolvedor tome a decisão explicitamente. Para ativar os redirecionamentos, passe follow_redirects=True. Esse comportamento é mais próximo da filosofia do curl.
axios (JavaScript, Node.js)
No ambiente Node.js, o axios segue redirecionamentos automaticamente por padrão. Você pode limitar ou desativar isso com o parâmetro maxRedirects. Se definir maxRedirects: 0, o redirecionamento automático é desativado, e o axios retornará um erro ou uma resposta com o código de redirecionamento, dependendo das configurações.
fetch (navegador e Node.js)
O fetch padrão segue redirecionamentos automaticamente por padrão. Você pode controlar isso com o parâmetro redirect, que aceita três valores: follow – seguir, manual – não seguir e retornar uma resposta opaca, error – tratar o redirecionamento como erro.
Dica: Lembre-se de dois grupos. curl e httpx, por padrão, NÃO seguem – você decide. requests, axios e fetch seguem por padrão. Se você estiver migrando código entre essas ferramentas, verifique a configuração de redirecionamentos, caso contrário a lógica quebra silenciosamente.
⚠️ Atenção: A diferença no comportamento padrão é a causa número um de bugs misteriosos ao reescrever scripts de um cliente para outro. O script no requests funcionava, você migrou para o httpx e, de repente, em vez da resposta final, recebe um código 302. O motivo é que o httpx não segue sozinho. Sempre defina explicitamente a configuração de redirecionamentos.
✅ Verificação: Você consegue dizer de memória o comportamento padrão de curl, requests, httpx, axios e fetch e conhece o parâmetro para controlar redirecionamentos em cada um.
Passo 4: Controle manual de redirecionamentos – quando é o único caminho certo
Objetivo desta etapa: aprender a desativar o redirecionamento automático e processar cada etapa do redirecionamento manualmente, com controle total sobre o método, o corpo e os cabeçalhos.
O redirecionamento automático é prático, mas em três situações ele é prejudicial, e o controle manual é necessário:
- Quando você precisa preservar o Authorization ao mudar para outro domínio.
- Quando é importante saber exatamente por qual proxy e IP passou cada etapa da cadeia.
- Quando o servidor responde com 302 onde logicamente seria necessário 307, e você quer preservar o método POST manualmente.
Desativando o redirecionamento automático: curl
No curl é simples: não adicione a flag -L. O cliente mostrará a primeira resposta. Depois, você pega o Location e faz uma nova requisição:
curl -i -x $PROXY_URL "https://example.com/login"Leia o cabeçalho Location da saída e, em seguida, execute a próxima requisição manualmente, adicionando os cabeçalhos necessários:
curl -i -x $PROXY_URL -H "Authorization: Bearer TOKEN" "https://example.com/next"Desativando o redirecionamento automático: requests
Aqui usamos o parâmetro allow_redirects=False e processamos a cadeia em um loop:
import os, requests; proxies = {"http": os.environ["PROXY_URL"], "https": os.environ["PROXY_URL"]}; url = "https://example.com/login"; method = "POST"; body = {"user": "a", "pass": "b"}; headers = {"Authorization": "Bearer TOKEN"};
for _ in range(5):
r = requests.request(method, url, json=body, headers=headers, proxies=proxies, allow_redirects=False);
if r.status_code not in (301, 302, 303, 307, 308): break;
loc = r.headers["Location"];
if r.status_code in (301, 302, 303): method = "GET"; body = None;
url = loc
Observe: neste loop, você decide se muda o método ou não, e decide se mantém o cabeçalho Authorization. É exatamente aí que está o poder do controle manual.
Desativando o redirecionamento automático: httpx
Como o httpx não segue por padrão, basta não ativar o follow_redirects. A lógica do loop é semelhante à do requests: verifique o código, leia o Location, tome decisões sobre método e cabeçalhos e faça a próxima requisição.
Desativando o redirecionamento automático: axios
No axios, defina maxRedirects: 0. Ao receber um código de redirecionamento, o axios no Node.js lançará um erro cujo objeto de resposta terá o status e os cabeçalhos acessíveis. Do cabeçalho Location você pega o novo endereço e monta a próxima requisição.
Desativando o redirecionamento automático: fetch
No fetch, passe redirect: "manual". Assim, o fetch não seguirá e retornará uma resposta da qual você lerá os dados necessários para o próximo passo.
Dica: No controle manual, sempre registre quatro coisas em cada etapa: o URL original, o código recebido, o valor do Location e o método da próxima requisição. Isso transforma uma cadeia confusa em uma sequência transparente, fácil de ler e depurar.
⚠️ Atenção: No controle manual, você é responsável pela segurança. Antes de transferir o Authorization para um novo endereço do Location, verifique se o domínio pertence à sua infraestrutura confiável. Copiar segredos cegamente para qualquer endereço do Location é uma vulnerabilidade séria.
✅ Verificação: Você tem um loop de tratamento manual funcional em pelo menos um cliente, que percorre corretamente a cadeia de redirecionamentos e preserva os cabeçalhos necessários apenas para domínios confiáveis.
Passo 5: Limitando a profundidade e se protegendo contra loops
Objetivo desta etapa: proteger seu código contra redirecionamentos infinitos e impedir que o loop de transições trave a aplicação.
Às vezes, os servidores estão mal configurados, e o endereço A aponta para o endereço B, que aponta de volta para A. Se o seu cliente segue sem limites, ele entra em loop. No tratamento manual, o perigo é o mesmo: um loop sem contador vai rodar para sempre.
Limitando o número de redirecionamentos
Sempre defina uma profundidade máxima. Um valor razoável é de cinco a dez redirecionamentos. Mais do que isso é raro em cenários normais.
- No curl: a flag
--max-redirs 10junto com-L. - No requests: a biblioteca limita a profundidade sozinha, mas em um loop manual use
range(10). - No httpx: o parâmetro
max_redirectscom redirecionamentos ativados. - No axios: o parâmetro
maxRedirectscom o número desejado. - No fetch: no tratamento manual, conte os redirecionamentos você mesmo no loop.
Proteção contra loops rastreando URLs visitados
Um truque confiável: mantenha um conjunto de URLs já visitados. Antes de cada redirecionamento, verifique se você já esteve naquele endereço. Se sim, interrompa a cadeia com um erro. Isso pega até loops complexos com vários endereços.
seen = set();
while url and url not in seen:
seen.add(url);
r = requests.request(method, url, headers=headers, proxies=proxies, allow_redirects=False);
if r.status_code not in (301,302,303,307,308): break;
url = r.headers["Location"]
Dica: Combine as duas técnicas: um limite rígido de quantidade e um conjunto de URLs visitados. O limite protege contra cadeias longas; o conjunto, contra loops. Juntos, eles oferecem proteção completa.
✅ Verificação: Seu código termina garantidamente em qualquer cadeia de redirecionamentos, mesmo que o servidor crie um loop infinito. Ou ele chega à resposta final, ou interrompe com um erro claro sobre profundidade excedida ou loop detectado.
Passo 6: Redirecionamentos e mudança de IP – por que a cadeia vai para outro proxy
Objetivo desta etapa: entender como a rotação de proxies interage com redirecionamentos e evitar que etapas da cadeia passem por IPs diferentes.
Esse é um ponto sutil e muitas vezes subestimado. Se você usa um pool de proxies Proxeon com rotação de IP, é importante entender em que nível a troca de endereço acontece.
Por que as etapas podem passar por IPs diferentes
Imagine que sua rotação esteja configurada para trocar o IP a cada nova conexão. No redirecionamento automático, o cliente pode abrir uma nova conexão para a próxima etapa do redirecionamento. Se, entre as etapas, a rotação fornecer um novo IP, a primeira requisição sai de um endereço, e o redirecionamento pelo Location já sai de outro. Para muitos servidores, isso parece suspeito: a autenticação foi iniciada por um cliente, mas continuada como se fosse outro.
O que quebra com isso
- Sessões vinculadas ao IP são encerradas. O servidor vê que a continuação veio de outro endereço e descarta a sessão.
- Cookies emitidos para uma sessão específica deixam de ser aceitos.
- Lógicas que esperam uma fonte única dentro da cadeia começam a se comportar de forma instável.
Como manter uma sessão em um único IP
A chave é fixar o IP durante toda a cadeia. O Proxeon suporta o modo de sessão sticky, em que o mesmo IP é mantido por um período definido. Use-o para cenários em que a integridade da cadeia de redirecionamentos é importante.
- Escolha nas configurações de conexão o modo de sessão sticky em vez de rotação a cada requisição.
- Defina um tempo de retenção do IP com folga para toda a cadeia de redirecionamentos.
- No código, use uma única sessão de cliente para todas as etapas: no requests, o objeto
requests.Session(); no httpx, ohttpx.Client(). - Garanta que você está reutilizando a conexão, e não criando uma nova a cada etapa.
Dica: Para a integridade da cadeia de redirecionamentos, sempre crie um objeto de sessão de cliente e execute todas as etapas por ele. Isso reutiliza a conexão, preserva cookies entre requisições e reduz a chance de mudar de IP no meio da cadeia.
⚠️ Atenção: Não confunda sessão sticky com retenção infinita de IP. Defina um tempo razoável de retenção – apenas o necessário para a operação. Lembre-se de que todo o trabalho com proxy deve estar em conformidade com a legislação e as regras dos recursos com os quais você interage.
✅ Verificação: Toda a cadeia de redirecionamentos passa pelo mesmo IP, a sessão não é interrompida, e os cookies são aceitos em cada etapa. Para verificar, consulte em cada etapa um serviço que mostre seu IP atual e confirme que ele não mudou.
Passo 7: Depuração – como ver toda a cadeia e os códigos etapa por etapa
Objetivo desta etapa: obter uma visão completa da cadeia de redirecionamentos para saber exatamente onde o método ou o cabeçalho se perde.
Depurar no escuro é a pior coisa que se pode fazer com redirecionamentos. Abaixo estão as ferramentas que tornam a cadeia visível.
Log completo no curl
A flag -v ativa o modo detalhado. Você verá cada requisição, cada resposta, todos os cabeçalhos e todos os redirecionamentos. Com a flag -L, o curl mostra toda a cadeia de uma vez.
curl -v -L --max-redirs 10 -x $PROXY_URL "https://example.com/login"Leia a saída de cima para baixo. As linhas que começam com o símbolo de maior são o que vai para o servidor. As linhas com o símbolo de menor são o que vem na resposta. Assim você verá em qual etapa o cabeçalho sumiu.
Histórico de redirecionamentos no requests
Se você mantiver o redirecionamento automático ativado, a resposta final terá o atributo history – uma lista de todas as respostas intermediárias. Percorra-a e imprima o código e o URL de cada etapa:
r = requests.post(url, json=body, proxies=proxies);
for h in r.history: print(h.status_code, h.url);
print("final", r.status_code, r.url)
Histórico de redirecionamentos no httpx
Com o follow_redirects ativado, a resposta do httpx também tem a propriedade history. A lógica é a mesma: percorra e imprima o código e o URL de cada resposta intermediária.
Depuração no axios e no fetch
No axios, no tratamento manual, registre cada resposta no loop você mesmo. No fetch com o modo manual, imprima o status e o cabeçalho Location em cada etapa. Não há uma lista de histórico embutida, então o registro manual é sua principal ferramenta.
Dica: Crie um formato único de log para uma etapa: número da etapa, método, URL, código da resposta, Location, presença de Authorization. Esse registro em formato de tabela mostra instantaneamente onde o método virou GET ou o token sumiu. Isso economiza horas de depuração.
O que procurar nos logs
- O momento em que o método na requisição de saída virou GET em vez de POST. Isso indica um código 301, 302 ou 303.
- A etapa em que o cabeçalho Authorization desapareceu. Geralmente é uma mudança de domínio.
- A mudança de domínio ou protocolo no valor do Location – é aí que cookies com flags se perdem.
- Endereços repetidos – sinal de loop.
✅ Verificação: Você consegue exibir a cadeia completa de redirecionamentos com códigos e URLs em qualquer cliente e apontar a etapa exata em que o método mudou ou um cabeçalho sumiu.
Verificação do resultado: checklist
Percorra esta lista. Se todos os itens forem atendidos, você tem controle total sobre redirecionamentos.
- Você conhece o comportamento do método e do corpo para os códigos 301, 302, 307 e 308.
- Você entende por que o Authorization some ao mudar de domínio.
- Você conhece o comportamento padrão de curl, requests, httpx, axios e fetch.
- Você tem um exemplo funcional de desativação do redirecionamento automático.
- Você tem um loop funcional de tratamento manual de cadeia.
- Seu código está protegido contra loops infinitos com limite e conjunto de URLs visitados.
- Você usa a sessão sticky do Proxeon para a integridade da cadeia, quando necessário.
- Você sabe como exibir a cadeia completa de redirecionamentos nos logs.
Como testar
Pegue um endpoint de teste que responde com o código 302 a uma requisição POST. Execute-o com o redirecionamento automático e confirme que o método virou GET. Em seguida, execute-o com o tratamento manual preservando o método e confirme que o POST chegou ao endereço final. A diferença de comportamento será a prova de que você tem controle total.
✅ Verificação: Ambos os cenários – automático e manual – produzem resultados previsíveis e explicáveis, não aleatórios.
Erros comuns e soluções
Vamos analisar as armadilhas mais frequentes e como evitá-las.
Erro 1: POST virou GET
Causa: o servidor retornou um código 301 ou 302, e o cliente, pela regra histórica, mudou o método. Solução: se você controla o servidor, retorne 307 ou 308. Se não, desative o redirecionamento automático e repita a requisição com o método correto manualmente.
Erro 2: o cabeçalho Authorization sumiu
Causa: o redirecionamento levou a outro domínio, e o cliente removeu o segredo por segurança. Solução: verifique o domínio do Location e, se for confiável, adicione o Authorization à próxima requisição manualmente.
Erro 3: o script funcionava no requests, mas quebrou no httpx
Causa: o httpx não segue redirecionamentos por padrão, enquanto o requests segue. Solução: defina explicitamente follow_redirects=True no httpx ou, inversamente, adote o tratamento manual em todos os lugares para manter a consistência.
Erro 4: a aplicação travou em uma cadeia
Causa: loop infinito de redirecionamentos sem limite de profundidade. Solução: adicione um limite de redirecionamentos e um conjunto de URLs visitados, como mostrado no Passo 5.
Erro 5: a sessão é interrompida no meio da cadeia
Causa: as etapas da cadeia passaram por IPs diferentes devido à rotação de proxy. Solução: ative a sessão sticky do Proxeon e use um único objeto de sessão de cliente para todas as etapas.
Erro 6: o cookie não é enviado após o redirecionamento
Causa: os flags Secure, Domain ou SameSite não coincidem com o novo endereço. Solução: verifique o protocolo e o domínio no Location e garanta que correspondam aos flags do cookie. Não remova flags de segurança por conveniência.
Erro 7: o curl não segue o redirecionamento
Causa: você esqueceu a flag -L. Solução: adicione -L para o redirecionamento automático ou deixe sem para controle manual – dependendo da tarefa.
Recursos adicionais e otimização
Quando a base estiver dominada, vale a pena organizar e aumentar a confiabilidade.
Módulo único de tratamento de redirecionamentos
Não espalhe a lógica pelo código. Centralize o tratamento da cadeia em uma única função com parâmetros: lista de domínios confiáveis, profundidade máxima, conjunto de códigos para preservar o método. Assim, o comportamento fica uniforme em todo o projeto.
Lista branca de domínios para o Authorization
Crie uma lista explícita de domínios para os quais é permitido enviar o Authorization em redirecionamentos. Tudo o que estiver fora da lista nunca recebe o segredo. Isso torna a segurança gerenciável, não acidental.
Métricas de cadeias
Colete estatísticas: comprimento médio da cadeia, proporção de requisições com redirecionamentos, códigos mais comuns. Um aumento anômalo no comprimento das cadeias é um sinal precoce de problemas no servidor de destino.
Dica: Configure um alerta se a cadeia exceder três redirecionamentos. Na maioria dos cenários corretos, um ou dois são suficientes. Um aumento repentino é motivo para investigar o que mudou no recurso de destino.
FAQ: perguntas frequentes sobre tratamento de redirecionamentos
Por que o POST vira GET se eu não mudei nada?
Porque o servidor retornou um código 301 ou 302, e seu cliente, pela regra histórica, mudou o método para GET. Para evitar isso, é necessário um código 307 ou 308 ou o tratamento manual.
O proxy muda o método da requisição em um redirecionamento?
Não. O Proxeon e qualquer proxy correto apenas repassam o status e o Location. A decisão de mudar o método é do seu cliente HTTP. Procure a causa nas configurações do cliente.
Como preservar o Authorization ao mudar para outro domínio?
Apenas manualmente. Desative o redirecionamento automático, verifique o domínio do Location, confirme se é confiável e adicione o cabeçalho Authorization à próxima requisição você mesmo.
Qual código é melhor para redirecionar um POST?
O código 307 para redirecionamento temporário e o 308 para permanente. Ambos preservam o método e o corpo da requisição, evitando surpresas para os clientes.
Por que o mesmo script se comporta de forma diferente no requests e no httpx?
Porque o requests segue redirecionamentos por padrão, enquanto o httpx não. Defina explicitamente a configuração de redirecionamentos para que o comportamento coincida.
Como me proteger contra um loop infinito de redirecionamentos?
Defina um limite rígido de redirecionamentos e mantenha um conjunto de URLs já visitados. Se um endereço se repetir ou o limite for excedido, interrompa a cadeia com um erro.
Por que a sessão é interrompida no meio da cadeia de redirecionamentos?
Provavelmente, as etapas passaram por IPs diferentes devido à rotação. Ative a sessão sticky do Proxeon e use um único objeto de sessão de cliente para todas as etapas.
Por que o cookie não é enviado após o redirecionamento?
Por causa da incompatibilidade dos flags Secure, Domain ou SameSite com o novo endereço. Verifique o protocolo e o domínio no Location. Flags de segurança não podem ser removidos.
Como ver toda a cadeia de redirecionamentos?
No curl, use -v -L. No requests e no httpx, use o atributo history da resposta final. No axios e no fetch, registre cada etapa manualmente.
Posso proibir totalmente os redirecionamentos?
Sim. No curl, não adicione -L; no requests, defina allow_redirects=False; no httpx, não ative o follow_redirects; no axios, defina maxRedirects: 0; no fetch, use redirect: "manual".
Conclusão
Agora você tem um panorama completo e prático de como trabalhar com redirecionamentos via proxy. Você entendeu por que o POST vira GET e sabe que o culpado não é o proxy, mas as regras históricas de processamento dos códigos 301 e 302. Você entende a diferença entre 301, 302, 307 e 308 e sabe escolher o código certo. Você sabe quais dados se perdem no redirecionamento: Authorization em outro domínio, cabeçalhos personalizados, cookies com flags de segurança.
Você estudou o comportamento padrão do curl, requests, httpx, axios e fetch e não vai mais se surpreender com as diferenças ao migrar código. Você tem exemplos práticos de desativação do redirecionamento automático e tratamento manual da cadeia com controle total do método e dos cabeçalhos. Você sabe se proteger contra loops e manter uma única sessão em um único IP com a sessão sticky do Proxeon. E, por fim, você sabe depurar cadeias e ver cada etapa.
O que fazer agora? Monte um módulo único de tratamento de redirecionamentos com lista branca de domínios para o Authorization e profundidade configurável. Adicione métricas de comprimento de cadeias. Execute seus cenários reais com o tratamento manual e compare com o automático – assim você encontrará pontos ocultos onde os dados se perdiam.
Siga em frente no estudo do stack de rede: aprofunde-se no ciclo de vida dos cookies, nos detalhes das conexões TLS e na reutilização de conexões. Cada uma dessas habilidades tornará seu trabalho com o proxy Proxeon ainda mais confiável e previsível. Bom trabalho de engenharia e que suas cadeias de requisições sejam limpas e transparentes.
