Pool de proxies dentro da aplicação: seleção de IP, health-check, quarentena e sticky-sessions
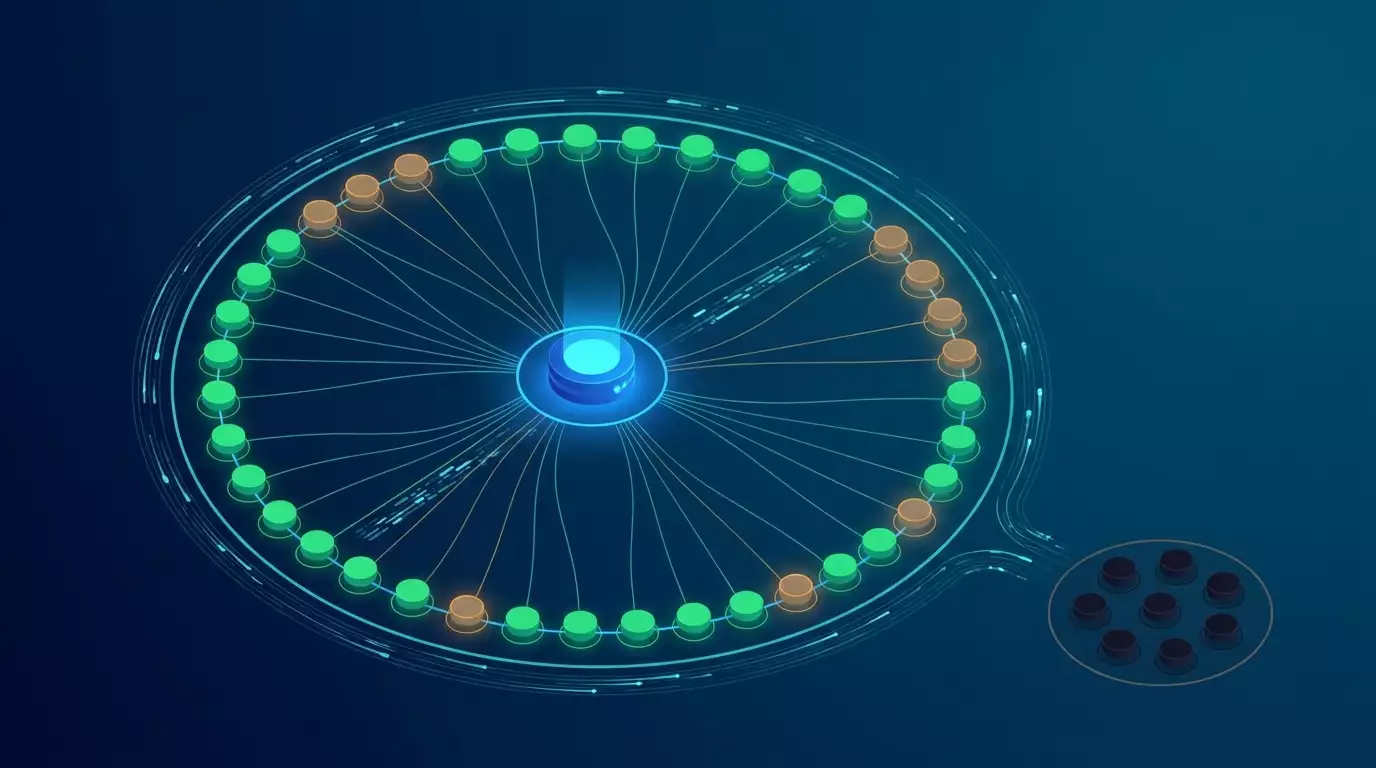
Sumário do artigo
- Por que uma lista de endereços em arquivo de texto quebra sob carga real
- Fundamentos: pool, aluguel de endereço por tarefa e o que considerar como sessão
- Aprofundamento: ciclo de vida de um endereço no pool
- Estratégias de seleção de endereço: do round-robin ao hash por chave
- Health-check: verificações passivas e ativas de saúde
- Quarentena e retorno ao serviço: espera, limites e proteção do pool
- Armazenamento de estado: memória do processo vs. armazenamento compartilhado
- Observabilidade: métricas por endereço e como distinguir ip ruim de site ruim
- Prática: esqueleto de pool em python e node.js
- Erros típicos: o que não fazer
- Ferramentas e recursos para implementação
- Casos e resultados de aplicação
- Perguntas frequentes
- Conclusão e próximos passos
Imagine a cena. Sexta-feira, fim de tarde, seu parser ou sistema de gerenciamento de contas finalmente foi lançado em produção. Nos primeiros minutos, tudo voa. Aí começa o estranho: parte das requisições cai, em algum lugar aparece captcha, outra conta pede verificação de identidade do nada, e os logs viram uma bagunça de erros de conexão. Familiar? Em nove de cada dez casos, a raiz do problema não está no site alvo nem na sua lógica de negócio. Está na forma como sua aplicação gerencia os endereços IP.
A maioria dos projetos começa com algo simples: um arquivo de texto com uma lista de endereços, leitura linha por linha, escolha aleatória. E funciona. Até o momento em que a carga se torna real. Aí a lista ingênua se desmancha, e você fica com falhas intermitentes impossíveis de reproduzir com uma requisição no console.
Este artigo é um guia completo para projetar um pool de proxies dentro da aplicação. Vamos analisar como escolher um endereço para uma tarefa específica, como verificar a saúde dos endereços, como colocar IPs problemáticos em quarentena e trazê-los de volta, e como manter uma sticky-session para uma mesma conta. É um tema de engenharia, mas vamos falar de forma acessível, com código, checklists e análise de erros reais.
Vamos logo definir os limites. Não vamos discutir timeouts e políticas de repetição para uma única requisição — esse é um tópico grande por si só. Também não vamos abordar como o endereço é fisicamente alterado no modem ou equipamento — isso é nível de infraestrutura, não de aplicação. Nosso foco é a lógica do pool no seu código.
Por que uma lista de endereços em arquivo de texto quebra sob carga real
Vamos olhar honestamente para uma implementação inicial típica. Existe um arquivo, com cem linhas de endereços. A aplicação lê o arquivo, coloca as linhas em um array e, a cada requisição, pega um elemento aleatório. Simples, compreensível, funciona na demonstração. Por que isso quebra?
Problema um: nenhuma memória do estado do endereço
A seleção aleatória de um array não sabe nada sobre o que aconteceu com o endereço um segundo atrás. Se o endereço número quarenta e sete acabou de retornar cinco erros consecutivos e claramente não está saudável, o algoritmo aleatório tem a mesma probabilidade de escolhê-lo novamente. Você vai bater repetidamente em um endereço morto, gastando tempo, retries e, mais importante, a confiança do site alvo nas suas ações.
Problema dois: nenhum vínculo entre tarefa e endereço
Quando você trabalha com contas, é crítico que uma mesma conta saia para a rede a partir do mesmo endereço. Os sistemas antifraude dos sites percebem quando a sessão de um único usuário salta por dezenas de sub-redes de diferentes zonas geográficas em poucos minutos. Isso não é natural. Uma pessoa real não se comporta assim. A seleção aleatória do arquivo garante essa bagunça.
Problema três: condições de corrida com múltiplos workers
Assim que você executa vários processos ou threads paralelos, um array simples na memória vira uma fonte de condições de corrida. Dois workers leem o mesmo índice, ambos pegam o mesmo endereço e ambos o sobrecarregam. Não há coordenação alguma. Contadores, se existirem, se perdem entre processos.
Problema quatro: nenhuma observabilidade
O arquivo de texto é mudo. Ele não vai te dizer qual endereço está dando oitenta por cento de captchas, qual ficou lento, qual já está morto há um dia. Você trabalha no escuro e descobre problemas apenas por sintomas indiretos nas métricas de negócio, quando já é tarde.
A conclusão é simples. A lista de endereços são dados. Gerenciar endereços sob carga é um sistema. A diferença entre eles é o tema do nosso artigo. A seguir, vamos construir esse sistema tijolo por tijolo.
Fundamentos: pool, aluguel de endereço por tarefa e o que considerar como sessão
Vamos começar pela base. Se você já é um engenheiro experiente, mesmo assim recomendo ler — aqui fixamos a terminologia que usaremos até o final do artigo.
O que é um pool de endereços
Um pool não é apenas uma lista de endereços, mas um objeto com comportamento. Ele armazena um conjunto de endereços junto com seu estado e fornece duas operações principais: fornecer um endereço para uma tarefa e devolvê-lo de volta. A analogia clássica é uma biblioteca. Você tem uma estante com livros, mas entre você e a estante está o bibliotecário. Ele sabe quais livros estão emprestados, quais estão danificados e enviados para reparo, e quais estão disponíveis. Você não remexe na estante — pede ao bibliotecário, e ele entrega o livro adequado.
Aluguel de endereço por tarefa
Aluguel é a vinculação temporária de um endereço a uma tarefa específica. O pool fornece um endereço, marca-o como ocupado ou considera que há nova carga nele, e, ao final da tarefa, o endereço é devolvido. É por isso que na interface do pool aparecem dois métodos que serão nossos cavalos de batalha: acquire — obter um endereço, e release — devolvê-lo com um relatório sobre o resultado.
O relatório na devolução é um detalhe fundamental. Quando a tarefa devolve o endereço, ela informa ao pool como tudo terminou: sucesso, erro de conexão, captcha, bloqueio. Essa informação alimenta toda a lógica posterior de saúde e quarentena.
Sticky-binding vs. seleção aleatória
Aqui passa uma fronteira importantíssima. Seleção aleatória é quando, a cada requisição, o pool fornece um endereço arbitrário. Esse modo é bom para tarefas onde não existe o conceito de sessão contínua: coleta massiva de dados públicos de páginas independentes, onde cada requisição é por si só.
Sticky-binding é quando uma determinada chave, por exemplo o identificador da conta, sempre recebe o mesmo endereço. Isso é crítico onde a continuidade da identidade ao longo do tempo é importante. Trabalhar com conta é um exemplo típico. A conta deve ser vista pelo site como um usuário estável, não como um enxame de entidades pulando pela rede.
O que considerar como sessão no nível da tarefa de negócio
A palavra sessão é sobrecarregada. No nível HTTP é uma coisa, no TCP é outra. Mas o que nos interessa é a sessão de negócio. É uma sequência logicamente conectada de ações que, do ponto de vista do site, deve vir do mesmo usuário do mesmo endereço.
Exemplos de sessões de negócio:
- Login em uma conta, série de ações dentro dela, logout — tudo do mesmo endereço.
- Cenário de múltiplas etapas: abrir ficha, adicionar ao carrinho, finalizar compra — todas as etapas conectadas.
- Trabalho durante um dia inteiro sob o mesmo perfil, onde a troca de endereço pareceria uma mudança suspeita.
Definir os limites da sessão é uma decisão de projeto sua, não uma imposição técnica. É você quem decide se a sessão dura quinze minutos, uma hora ou até o logout explícito. Dessa definição depende por quanto tempo o pool mantém a vinculação da chave ao endereço. Vamos guardar isso — voltaremos ao tópico de sticky-sessions várias vezes.
Aprofundamento: ciclo de vida de um endereço no pool
Antes de analisar estratégias individuais, é útil ter uma visão geral. Cada endereço em um pool bem construído tem um ciclo de vida, um conjunto de estados entre os quais ele transita.
Estados do endereço
- Healthy (saudável) — endereço disponível para fornecimento, métricas normais.
- Degraded (degradado) — endereço ainda é fornecido, mas com peso reduzido, porque os indicadores pioraram.
- Quarantined (em quarentena) — endereço temporariamente excluído do fornecimento, está em espera.
- Probing (em teste) — endereço passando por verificação ativa antes de retornar ao serviço.
- Dead (morto) — endereço considerado inoperante por muito tempo ou para sempre.
As transições entre estados são exatamente o sistema que estamos construindo. Um endereço saudável, ao acumular erros, degrada. Um degradado, ao atingir o limite, vai para quarentena. Da quarentena, após a espera, ele vai para teste. Passou no teste? Volta saudável. Não passou? Volta à quarentena com espera aumentada. Várias falhas consecutivas? O endereço é considerado morto.
Por que é necessária uma camada de abstração
Insight fundamental: a aplicação não deve saber dos estados do endereço. O código de aplicação apenas pede um endereço e o devolve com um resultado. Toda a complexidade do ciclo de vida fica escondida dentro do pool. Isso é o princípio de encapsulamento, e ele se paga cem vezes. Quando você quiser mudar a estratégia de quarentena, altera um módulo, não dezenas de lugares na lógica de negócio.
Modelo mental da carga
É bom ter em mente três eixos pelos quais o endereço vive:
- Atualidade — há quanto tempo verificamos sua saúde pela última vez.
- Carga — quantas tarefas estão pendentes nele agora.
- Reputação — histórico acumulado de sucessos e fracassos.
Qualquer estratégia de seleção, no fundo, combina esses três eixos em uma única avaliação. A seguir, vamos analisar estratégias concretas.
Estratégias de seleção de endereço: do round-robin ao hash por chave
O coração do pool é o algoritmo que decide qual endereço fornecer na próxima chamada acquire. Não existe uma resposta única correta. A escolha da estratégia é ditada pela tarefa. Vamos analisar quatro abordagens básicas e explicar quando cada uma é adequada.
Round-robin: em círculo
Round-robin é o algoritmo justo mais simples. Os endereços são dispostos em um anel, e um ponteiro avança um a cada requisição. Percorreu todo o círculo? Começa de novo. Ponto positivo: distribuição perfeitamente uniforme da carga quando os endereços são iguais. Ponto negativo: o algoritmo é cego para diferenças entre endereços. Rápido e lento recebem a mesma parcela de tráfego.
Quando usar: pool homogêneo, tarefas sem sessões, quando todos os endereços são aproximadamente iguais em qualidade e capacidade.
Seleção ponderada
Seleção ponderada é uma evolução do round-robin onde cada endereço recebe um peso. Um endereço com peso maior recebe mais tráfego. O peso pode ser definido estaticamente, com base na capacidade conhecida, ou dinamicamente, recalculado com base em métricas ao vivo: taxa de sucesso e latência.
Peso dinâmico é uma ferramenta poderosa. O endereço começou a retornar mais captchas? Reduzimos seu peso, ele recebe menos tráfego, mas não é removido totalmente. Os indicadores se recuperaram? O peso sobe de volta. É uma autorregulação suave, mais suave do que uma remoção abrupta para quarentena.
Uma fórmula simples para o peso: peso igual à taxa de sucesso dividida pela latência normalizada. Quanto maior o sucesso e menor a latência, maior o peso. Recalcule-o em uma janela deslizante, por exemplo, com base nos últimos cinquenta pedidos.
Least-connections: o menos carregado
Least-connections fornece o endereço que tem o menor número de tarefas ativas no momento. Isso funciona brilhantemente quando as tarefas têm durações muito diferentes. O round-robin, nessa situação, pode sobrecarregar um endereço com tarefas longas enquanto outro fica ocioso. O least-connections equilibra a carga real, não o número de pedidos distribuídos.
Para implementar, é necessário um contador de aluguéis ativos por endereço. Ele aumenta no acquire e diminui no release. O endereço com o menor contador é escolhido. Observação: esse contador é estado compartilhado e, com múltiplos workers, deve viver em um armazenamento comum. Voltaremos a isso na seção sobre estado.
Hash por chave: uma conta — sempre o mesmo endereço
Agora, o principal para trabalhar com contas. Hash por chave é uma estratégia onde o endereço é escolhido não aleatoriamente, mas deterministicamente, com base na chave da tarefa. Pegamos o identificador da conta, calculamos um hash, tiramos o resto da divisão pelo número de endereços — obtemos um índice. A mesma conta sempre dará o mesmo índice e, portanto, o mesmo endereço.
Por que isso não é apenas conveniente, mas fundamental? Aqui está o insight principal de todo o artigo.
Por que o hash determinístico é mais importante que a aleatoriedade para o antifraude
Os sistemas antifraude dos sites constroem um perfil de comportamento do usuário. Um dos sinais mais fortes de confiança é a estabilidade do ambiente de rede. Uma pessoa real, dia após dia, acessa a rede aproximadamente de um conjunto fixo de endereços. O provedor muda raramente, a geografia é estável.
Agora imagine que uma conta, a cada ação, exibe um novo endereço de uma sub-rede diferente. Para o sistema, isso parece um comportamento impossível: uma pessoa não pode estar fisicamente em dez lugares em um minuto. A seleção aleatória de endereço gera exatamente essa bandeira vermelha.
O hash determinístico resolve o problema na raiz. A conta é vinculada ao endereço matematicamente, sem armazenamento de estado. Mesmo que a aplicação seja reiniciada e perca toda a memória, a mesma conta calculará o mesmo endereço novamente. É uma vinculação autorrecuperável. Bonito, não?
Pedra no caminho: alteração no tamanho do pool
O hash ingênuo por resto de divisão tem uma fraqueza traiçoeira. Se o número de endereços muda — um foi adicionado ou colocado em quarentena — o resto da divisão muda para quase todas as chaves. Praticamente todas as contas de repente migrarão para novos endereços. Isso é exatamente o desastre que tentávamos evitar.
Solução — hash consistente. É uma técnica em que adicionar ou remover um endereço reassigna apenas uma pequena fração das chaves, não todas. Os endereços e chaves são colocados em um anel imaginário; a chave percorre o anel até o endereço mais próximo. Removeu um endereço? Apenas as chaves dele se movem; as outras permanecem no lugar. O hash consistente é a base correta para sticky-binding em um pool vivo, onde endereços entram e saem.
Combinação de estratégias
Em uma aplicação real, as estratégias frequentemente se combinam. Um cenário avançado típico: para tarefas com chave de conta, usamos hash consistente; dentro do grupo de endereços responsável pela reserva, aplicamos least-connections. Para coleta de dados sem sessão — round-robin ponderado. O pool pode ter várias estratégias e escolher a adequada pelo tipo de tarefa.
Checklist de seleção de estratégia
- Existe conceito de sessão ou vínculo com conta? Use hash por chave, de preferência consistente.
- Tarefas independentes e homogêneas? Round-robin.
- Endereços de qualidades diferentes? Seleção ponderada com peso dinâmico.
- Tarefas com durações muito diferentes? Least-connections.
- Carga mista? Combinação com divisão do pool em subgrupos.
Health-check: verificações passivas e ativas de saúde
O pool é tão bom quanto o conhecimento que tem sobre o estado de seus endereços. Daí o mecanismo de verificação de saúde, health-check. Existem duas abordagens complementares: passiva e ativa. Ambas são necessárias.
Health-check passivo por erros de tráfego
Verificação passiva não faz requisições separadas. Ela observa o tráfego real que já está passando pelo endereço. Cada chamada release traz um resultado, e o pool, com base nele, atualiza a reputação do endereço. Isso é gratuito — você já fez a requisição a negócio, apenas contabilizou seu resultado.
O que considerar como sinal de degradação na observação passiva:
- Erros de conexão: o endereço não responde, queda de link.
- Respostas características de bloqueio no nível de rede.
- Explosão de captchas — sinal indireto, mas importante, de queda de reputação do endereço.
- Aumento repentino da latência em relação à média histórica do endereço.
Ponto positivo da abordagem passiva: atualidade e nenhuma carga adicional. Ponto negativo: ela reage apenas quando o tráfego já foi enviado, ou seja, as primeiras requisições prejudicadas são inevitáveis. E ela não sabe nada sobre endereços que estão ociosos no momento.
Health-check ativo por meio de sondas
Verificação ativa é uma sonda separada que o pool faz por conta própria, independentemente do tráfego de trabalho. Geralmente é uma requisição leve a um recurso de controle previamente conhecido, que responde de forma estável e permite avaliar a operacionalidade do endereço.
As sondas ativas resolvem o que a passiva não consegue: verificam endereços ociosos e endereços em quarentena antes de retorná-los. É exatamente a sonda ativa que decide se o endereço sai da quarentena de volta ao serviço.
O que considerar como falha na verificação
Definir falha é um ponto delicado. Muito rigoroso — e você descartará endereços normais por causa de um pico aleatório. Muito brando — e endereços mortos ficarão pendurados no pool. Uma abordagem razoável é um limite multifatorial.
- Um erro isolado não é falha. É ruído. A rede não é confiável por natureza.
- Falha é um sinal acumulado: por exemplo, três erros nas últimas cinco requisições, ou a taxa de sucesso na janela caiu abaixo de setenta por cento.
- Separadamente, a taxa de captchas. O limite aqui é mais baixo, porque captcha é um sinal sobre a reputação do endereço, não sobre uma falha aleatória.
Quais intervalos adotar
Os intervalos das sondas ativas são uma questão de equilíbrio entre atualidade dos dados e carga desnecessária. Orientações gerais:
- Endereços saudáveis sob carga podem nem ser sondados ativamente — o tráfego passivo fala por eles.
- Endereços saudáveis ociosos — sonda a cada trinta a sessenta segundos, para mantê-los prontos.
- Endereços em quarentena — sonda de acordo com o cronograma de espera, que veremos a seguir.
- Não sonde todos os endereços ao mesmo tempo. Distribua as sondas no tempo, adicione um deslocamento aleatório, para não criar picos síncronos.
Flapping e como a histerese o mitiga
Agora, um dos fenômenos mais subestimados. Flapping é quando um endereço oscila rapidamente entre os estados saudável e doente. A sonda passou — voltou ao serviço. Imediatamente um erro — removeu. Um segundo depois, a sonda passou novamente — voltou. E assim por diante. Isso desgasta o sistema, cria oscilações nas métricas e não deixa o endereço nem trabalhar nem descansar.
O tratamento é a histerese. Termo da eletrônica que significa limites diferentes para entrada e saída de um estado. A ideia é simples: para reconhecer um endereço como doente, precisamos de menos sinais do que para reconhecê-lo como saudável novamente. Por exemplo, três erros consecutivos levam à quarentena, mas para voltar são necessárias cinco sondas bem-sucedidas consecutivas. A assimetria dos limites cria uma zona de estabilidade na qual pequenas oscilações não mudam o estado.
A segunda ferramenta contra flapping é o tempo mínimo de permanência no estado. Um endereço que entra em quarentena deve ficar lá por um tempo mínimo, mesmo que a sonda passe antes. Isso elimina oscilações rápidas. A combinação de histerese e tempo mínimo de espera transforma um sistema nervoso em algo calmo e previsível.
Checklist de health-check
- Ambos os tipos de verificação funcionam: passiva pelo tráfego e ativa por sondas.
- Falha definida como sinal acumulado, não erro isolado.
- Para taxa de captchas, um limite separado e mais sensível.
- Sondas ativas distribuídas no tempo com deslocamento aleatório.
- Histerese configurada: limite de entrada no problema menor que o limite de saída.
- Tempo mínimo de permanência no estado contra flapping.
Quarentena e retorno ao serviço: espera, limites e proteção do pool
Quando um endereço é considerado problemático, não podemos simplesmente descartá-lo. Frequentemente o problema é temporário. A tarefa da quarentena é dar um descanso ao endereço e depois verificar se ele se recuperou. Há muita engenharia fina aqui.
Espera exponencial
A quarentena ingênua mantém o endereço por um tempo fixo, digamos um minuto, e o retorna. Mas se o endereço for problemático de forma consistente, você estará retornando-o repetidamente, cada vez recebendo uma nova leva de falhas. Solução — espera exponencial.
Princípio: a cada nova entrada em quarentena, o tempo de espera aumenta. Primeira vez — um minuto. Segunda vez consecutiva — dois minutos. Depois quatro, oito, dezesseis. Até um teto razoável, como uma hora. Assim que o endereço opera com sucesso por tempo suficiente, o contador de espera é zerado para o valor inicial.
Isso resolve elegantemente duas tarefas. Um endereço que tropeçou temporariamente volta rapidamente. Já um endereço consistentemente doente incomodará o sistema cada vez menos, até se tornar praticamente morto, sem poluir o pool com sondas inúteis frequentes.
Adicione à espera uma variação aleatória, o chamado jitter. Sem ele, todos os endereços que entraram em quarentena ao mesmo tempo retornarão juntos. O jitter espalha os retornos no tempo.
Limite de endereços simultaneamente em quarentena
Aqui está uma proteção criticamente importante, a mais esquecida. O que acontece se ocorrer um incidente que afete metade dos endereços de uma vez? Por exemplo, o site alvo endureceu as verificações. O pool honestamente começará a colocar endereços em quarentena um após o outro. E se não colocarmos um limite, você pode ficar com quase ninguém em serviço.
Daí a regra: limite rígido para a proporção de endereços simultaneamente em quarentena. Por exemplo, não mais que trinta por cento do pool. Se o limite for atingido, novos candidatos à quarentena não são removidos, apenas têm seu peso reduzido. A lógica é: é melhor trabalhar com endereços levemente degradados do que ficar sem recursos nenhum.
Proteção contra a situação de todo o pool em quarentena
Isso é uma continuação da ideia anterior, levada ao caso extremo. Imagine: a própria sonda para o recurso de controle quebrou. O recurso caiu ou mudou a resposta. O pool decide que todos os endereços estão mortos e coloca o pool inteiro em quarentena. A aplicação para completamente, embora os endereços estejam, na verdade, bem.
Mecanismos de proteção:
- Mínimo garantido em serviço. Mantenha sempre pelo menos um ou dois endereços disponíveis, mesmo que formalmente não tenham passado na verificação. Melhor que funcionem sob suspeita do que o sistema parar.
- Análise de correlação. Se as falhas ocorrerem simultaneamente em todos os endereços — isso é suspeito. Provavelmente um fator comum quebrou: a sonda, a rede do seu lado, o recurso alvo. O pool deve ser capaz de reconhecer uma falha em massa e não entrar em pânico, não removendo todos de uma vez.
- Recursos de controle separados. Não dependa de um único ponto de controle para a sonda ativa. Se ele se tornar seu ponto único de falha, falsos positivos derrubarão todo o pool.
Retorno ao serviço por meio do estado semiaberto
O retorno da quarentena não é instantâneo. Uma boa prática é o estado semiaberto, ideia do padrão disjuntor (circuit breaker). O endereço que sai da quarentena não recebe tráfego total imediatamente. Primeiro, recebe uma pequena fração, um fluxo de teste. Se as requisições de teste forem bem-sucedidas, a fração aumenta gradualmente até que o endereço atinja o peso total. Se os testes falharem, volta para a quarentena com espera aumentada.
Esse ramp-up suave protege contra uma enxurrada prematura de tráfego em um endereço ainda não recuperado.
Checklist de quarentena
- A espera cresce exponencialmente em reincidências.
- Jitter adicionado à espera contra retornos síncronos.
- Limite definido para a proporção de endereços em quarentena simultaneamente.
- Mínimo de endereços em serviço garantido em qualquer circunstância.
- Reconhecimento de falha em massa como sinal de problema geral.
- Retorno via estado semiaberto com aumento gradual de tráfego.
Armazenamento de estado: memória do processo vs. armazenamento compartilhado
Toda a lógica que discutimos — contadores de carga, reputação, estados de quarentena — são dados que vivem em algum lugar. Onde exatamente é uma decisão arquitetural determinante. Ela depende de se você tem um ou vários processos.
Memória do processo: simples, mas solitário
Se a aplicação roda em um único processo, o estado do pool é mais facilmente mantido na memória. Estruturas de dados comuns: dicionário de endereços, seus contadores e temporizadores. Rápido, sem dependências, sem latência de rede.
As desvantagens são óbvias. Reiniciar — e todo o histórico se perde, o pool começa do zero, esquecendo quem estava em quarentena. E o principal: não funciona quando há mais de um processo. Cada processo terá sua visão isolada do mundo. Um coloca um endereço em quarentena, o outro não sabe e continua a sobrecarregá-lo.
Armazenamento compartilhado: Redis e Memcached
Assim que você tem vários workers — e sob carga real quase sempre são vários — o estado precisa se tornar compartilhado. Aqui entram em cena armazenamentos rápidos como Redis ou Memcached. Eles rodam como um serviço separado, acessado por todos os workers, e fornecem uma visão única e consistente do estado do pool.
O Redis é preferível ao Memcached na maioria dos casos, porque oferece operações atômicas, estruturas de dados como conjuntos ordenados e hashes, contadores com incremento atômico e a capacidade de executar pequenos scripts atomicamente. Tudo isso nos será útil.
Condições de corrida com múltiplos workers
O armazenamento compartilhado resolve o problema de visibilidade, mas cria um novo — condições de corrida. O cenário clássico do least-connections: dois workers leem os contadores simultaneamente, ambos veem que o endereço X é o menos carregado, ambos o escolhem, ambos incrementam o contador. No final, o endereço recebeu o dobro da carga, embora o algoritmo devesse ter evitado isso.
Soluções:
- Operações atômicas. Incrementar um contador no Redis é atômico por natureza. Use isso em vez de ler, aumentar e escrever separadamente.
- Scripts. Lógica complexa de seleção, onde é necessário ler vários valores e tomar uma decisão com base neles, implemente como um único script atômico no lado do armazenamento. Assim, ninguém se intrometerá entre a leitura e a escrita.
- Bloqueios distribuídos. Para seções críticas, pode-se usar um bloqueio curto. Mas cuidado — bloqueios prejudicam o desempenho e podem se tornar uma fonte de problemas. Operações atômicas são quase sempre melhores.
TTL de registros
Ferramenta importantíssima no armazenamento compartilhado — TTL, tempo de vida do registro, após o qual ele desaparece automaticamente. Isso salva de acúmulo de lixo e de estados travados.
Onde aplicar TTL:
- Sticky-binding de chave a endereço. Lembra da sessão de negócio? Sua duração é o TTL do registro de vinculação. Defina TTL de quinze minutos — e após quinze minutos de inatividade, a vinculação se desfaz sozinha; a conta, na próxima requisição, poderá obter uma nova vinculação. É uma forma limpa e elegante de expressar o tempo de vida da sessão.
- Contador de aluguéis ativos. Se um worker cair sem chamar release, o contador corre o risco de ficar artificialmente alto para sempre. TTL ou reconciliação periódica protegem contra isso. Frequentemente, o aluguel é implementado como um registro com TTL ligeiramente maior que a duração máxima da tarefa, para que um worker travado não segure o endereço para sempre.
- Estado de quarentena. O próprio tempo de espera é naturalmente expresso via TTL: o registro de quarentena vive exatamente o tempo da espera e, ao expirar, desaparece, abrindo caminho para o retorno.
Abordagem híbrida
Na prática, frequentemente se usa uma abordagem híbrida. Dados quentes, lidos com frequência, são cacheados localmente na memória do worker por um curto período, enquanto a fonte da verdade permanece no armazenamento compartilhado. Isso reduz o número de acessos ao Redis, mas exige cuidado com a dessincronização. Um bom compromisso é um cache local com TTL muito curto, por exemplo um ou dois segundos, para métricas que não exigem precisão instantânea.
Observabilidade: métricas por endereço e como distinguir IP ruim de site ruim
Não se pode gerenciar o que não se mede. A observabilidade transforma o pool de uma caixa-preta em um sistema transparente, onde você vê a saúde de cada endereço e entende as causas dos problemas.
Métricas por endereço
Conjunto mínimo que vale a pena manter para cada endereço em uma janela deslizante:
- Taxa de sucesso. Relação entre conclusões bem-sucedidas e o número total de tarefas. Principal indicador integral de saúde.
- Latência. Mantenha não apenas a média, mas percentis. A mediana e, digamos, o percentil 95 contarão muito mais sobre as caudas do que a média, que é facilmente distorcida por outliers.
- Taxa de captchas. Uma métrica separada e muito reveladora. O aumento da taxa de captchas em um endereço é um sinal precoce de queda de reputação, muitas vezes antes que erros diretos comecem a crescer.
- Número de aluguéis ativos. Carga atual, necessária para least-connections e para entender a distribuição.
- Histórico de quarentenas. Quantas vezes e por quanto tempo o endereço ficou em quarentena. Infratores crônicos são visíveis imediatamente.
Métricas do pool como um todo
- Proporção de endereços em cada estado: quantos saudáveis, degradados, em quarentena, mortos.
- Taxa de transferência total e taxa de sucesso agregada.
- Frequência de entradas em quarentena ao longo do tempo — um pico indica incidente.
- Ocupação do limite de quarentena — aproximar-se dele é um sinal de alerta.
Como distinguir IP ruim de site ruim
Aqui está uma questão que separa um sistema maduro de um ingênuo. Erros começaram a aparecer — mas quem é o culpado? O endereço problemático ou o próprio site alvo está temporariamente indisponível para todos? Se confundir, você começará a colocar endereços saudáveis em quarentena por pecados do servidor alheio.
Método de separação de diagnósticos — análise de correlação:
- Problema em um endereço. Se erros e captchas estão concentrados em um ou alguns endereços, enquanto os outros funcionam normalmente — a culpa é do endereço. Coloque-o em quarentena.
- Problema em todos os endereços para um mesmo site. Se em todos os endereços a taxa de sucesso caiu abruptamente especificamente para um site alvo, mas para outros está tudo bem — a culpa não é do pool, mas desse site. Colocar endereços em quarentena é inútil e prejudicial.
- Problema em todos os endereços para todos os sites. Provavelmente o problema está do seu lado: rede, infraestrutura, o próprio sistema de sondas. Aqui também não se pode culpar os endereços.
Conclusão prática: as métricas devem ser fatiadas não apenas por endereço, mas também pelo par endereço-site. Assim, a matriz de sucessos mostrará imediatamente onde a linha inteira está vermelha — culpa do endereço; onde a coluna inteira está vermelha — culpa do site. Essa representação bidimensional simples economiza horas de depuração e salva o pool de autodestruição à toa.
Logs e rastreamento
Além das métricas agregadas, é útil registrar as decisões do pool: por que este endereço foi escolhido, por que aquele foi enviado para quarentena. Quando algo der errado, esses rastros de decisões serão sua tábua de salvação. Não registre cada requisição em detalhes — você vai se afogar. Registre transições de estado e decisões atípicas.
Prática: esqueleto de pool em Python e Node.js
Vamos passar da teoria para o código. Analisaremos os trechos principais de implementação em duas plataformas populares. São esqueletos, arcabouços sobre os quais você pendurará as especificidades do seu projeto. Abstraímos detalhes para clareza das ideias principais: interface acquire e release, seleção de endereço e contabilização do resultado.
Interface: acquire e release
Vamos combinar o contrato. O método acquire recebe uma chave opcional — por exemplo, o identificador da conta para sticky-binding — e retorna um endereço. O método release recebe o endereço e o resultado da tarefa. O resultado é descrito minimamente por dois fatos: houve sucesso? e houve sinal de captcha ou bloqueio?
Esqueleto em Python
Vamos considerar um pool simplificado em Python. Mantemos a lógica na memória para clareza, mas indicamos onde se conecta o armazenamento compartilhado.
Elementos-chave da estrutura de dados: dicionário onde a chave é o endereço, o valor é um objeto de estado com campos de reputação, número de aluguéis ativos, timestamp de saída da quarentena e duração atual da espera. Separadamente, mantemos uma tabela de sticky-bindings chave-endereço.
Pseudocódigo do método acquire em Python-like: Primeiro, verificar se há chave. Se a chave foi fornecida e existe uma vinculação viva e o endereço vinculado está saudável — retorná-lo, renovando o TTL da vinculação. Se não há vinculação — selecionar um endereço por hash consistente a partir da chave entre os saudáveis, salvar a vinculação com TTL, retornar o endereço. Se não há chave alguma — aplicar a estratégia para tarefas sem sessão, por exemplo, seleção ponderada entre os saudáveis. Em todos os casos, incrementar o contador de aluguéis ativos do endereço escolhido.
Pseudocódigo do release: decrementar o contador de aluguéis ativos. Atualizar a janela deslizante de reputação com base no resultado — adicionar sucesso ou falha, contabilizar separadamente o sinal de captcha. Se os sinais acumulados ultrapassaram o limite de falha considerando histerese — colocar o endereço em quarentena: marcar o estado, calcular o tempo de espera como o base multiplicado por dois elevado ao número de repetições, limitado a um teto, adicionar jitter, definir TTL ou timestamp de retorno. Se o resultado for bom e o endereço estiver estável por muito tempo — zerar o contador de repetições de quarentena.
Um loop de fundo separado, em intervalos, percorre os endereços em quarentena cujo prazo de espera expirou e inicia uma sonda ativa. Passou com histerese o número necessário de vezes? Colocar o endereço em estado semiaberto com peso pequeno, depois gradualmente para saudável. Não passou? Prolongar a quarentena com espera aumentada.
Detalhes práticos importantes para implementação em Python: use assincronia se houver muitas tarefas paralelas; proteja o acesso a estruturas compartilhadas com sincronização adequada; ao migrar para vários processos, substitua os dicionários internos por chamadas ao Redis usando comandos atômicos e scripts. O contador de aluguéis ativos se encaixa perfeitamente em um incremento atômico; a vinculação chave-endereço, em um registro com TTL; o conjunto de endereços por estado é conveniente em conjuntos ordenados, onde o peso do endereço é sua avaliação.
Esqueleto em Node.js
Em Node.js, o modelo assíncrono é natural, e o pool geralmente é implementado como uma classe com métodos assíncronos acquire e release que retornam promises. A ideia é a mesma, muda a idiomática.
Estrutura de estado — objeto dicionário de endereços, onde o valor contém reputação como um buffer circular dos últimos resultados, contador de aluguéis ativos e campos de quarentena. Para vários workers, e no Node isso é frequentemente um cluster de processos, o estado também é externalizado para o Redis, porque cada processo é isolado.
Método acquire em Node: verificar assincronamente a sticky-binding via armazenamento; se existir vinculação viva e saudável — retornar e renovar TTL. Caso contrário, selecionar endereço — para chave, hash consistente; para tarefa sem sessão, ponderado. Incrementar atomicamente o contador de aluguéis. Retornar o endereço.
Método release em Node: decrementar atomicamente o contador. Registrar o resultado na janela de reputação. Verificar limites com histerese e, em caso de falha, colocar em quarentena com espera exponencial e jitter, respeitando o limite de endereços em quarentena — se o limite for atingido, em vez de quarentena, reduzir o peso.
Verificação em background em Node é convenientemente implementada via um timer periódico, que seleciona endereços com espera expirada e inicia sondas ativas, distribuindo-as no tempo. Sondas bem-sucedidas retornam o endereço suavemente, aumentando o peso em passos.
Conselho geral para ambas as plataformas: não tente fazer perfeito de primeira. Comece com round-robin mais health-check passivo mais quarentena simples na memória. Certifique-se de que a interface acquire e release seja conveniente para sua lógica de negócio. Depois, adicione sequencialmente: sticky via hash, sondas ativas, armazenamento compartilhado, limites e observabilidade. Deixe cada camada amadurecer sob carga real.
Minichecklist de implementação
- Interface reduzida a acquire com chave opcional e release com resultado.
- Toda a complexidade dos estados escondida dentro do pool; o código de negócio não sabe disso.
- Sticky implementado via hash determinístico, de preferência consistente.
- Contadores e vinculações atômicos com vários workers.
- Loop de fundo para sondas ativas de quarentena e endereços ociosos.
- Métricas escritas a cada release.
Erros típicos: o que não fazer
A teoria foi absorvida, o esqueleto foi construído. Agora, vamos passar pelos ancinhos em que se pisa repetidamente. Conhecer esses erros economizará semanas de depuração.
Pool único para diferentes sites
É tentador ter um único pool grande e passar por ele o tráfego para todos os sites alvo de uma vez. Não faça isso sem pensar. A reputação de um endereço em diferentes sites é diferente. Um endereço que funciona perfeitamente com um pode estar bloqueado em outro. Se você misturar tudo em um único pool e em uma única estatística, terá uma imagem turva, na qual um endereço bom para uma tarefa será injustamente punido por problemas com outra.
O correto é manter a reputação no par endereço-site e dividir logicamente os pools ou subgrupos para diferentes direções. Assim, a decisão de quarentena é tomada de forma pontual e justa.
Ausência de limite de tarefas por endereço
Mesmo um endereço saudável tem um limite. Se o pool alegremente pendura centenas de tarefas simultâneas em um endereço popular, você mesmo cria uma anomalia: concentração anormalmente alta de atividade a partir de um único ponto. Isso sobrecarrega o endereço e parece suspeito para o site.
Introduza um teto para o número de aluguéis simultâneos por endereço. Atingiu o teto? O endereço é temporariamente excluído dos candidatos; o tráfego vai para outros. Essa limitação simples protege de muitos males.
Rotação no meio da sessão
Pecado capital ao trabalhar com contas. A conta iniciou uma ação de um endereço e, devido a uma quarentena ou mudança no tamanho do pool, no meio da sessão migrou repentinamente para outro. Do ponto de vista do site, o usuário se teletransportou. Esse é um dos sinais mais evidentes de automação.
Proteção: enquanto houver uma sessão ativa, a vinculação da chave ao endereço deve ser intocável, mesmo que o endereço esteja um pouco degradado. Altere a vinculação apenas nos limites da sessão — ao seu término natural ou expiração do TTL. E se o endereço morrer de vez e não houver saída, é melhor encerrar a sessão corretamente do que transferi-la para outro endereço no meio do caminho.
Outros erros frequentes
- Erro único como sentença. Colocar o endereço em quarentena devido a uma única falha aleatória. A rede não é confiável; um erro isolado é normal. Apenas sinal acumulado.
- Ausência de histerese. Leva a flapping e oscilações, como discutimos.
- Espera fixa em vez de exponencial. Um endereço consistentemente doente retornará para sempre e estragará as estatísticas.
- Sem limite de quarentena. Um incidente pode colocar todo o pool em quarentena e parar o sistema.
- Sondas síncronas. Todos os endereços sondados ao mesmo tempo, criando picos de carga.
- Estado apenas na memória com vários workers. Cada processo vive em sua própria realidade; não há coordenação.
- Aluguéis travados. Release não foi chamado devido a uma falha; o contador fica artificialmente alto; o endereço é considerado sempre ocupado. Trate com TTL no aluguel.
- Confiança cega em um único recurso de controle. Ele cai — e todo o pool se considera morto.
Ferramentas e recursos para implementação
Vamos reunir o arsenal prático. O que realmente será útil ao construir o pool.
Armazenamentos de estado
- Redis. Principal escolha para estado compartilhado. Contadores atômicos, conjuntos ordenados para pesos e estados, hashes para metadados de endereço, TTL nativo, scripts para lógica complexa atômica. Praticamente ideal para nossa tarefa.
- Memcached. Mais simples e leve; serve se você precisar apenas de caches básicos com contadores, mas perde para o Redis na riqueza de estruturas e atomicidade de operações complexas.
Bibliotecas e abordagens por ecossistema
- Python. Stack assíncrono para tarefas paralelas, cliente Redis com suporte a assincronia e scripts, implementações prontas de hash consistente e o padrão circuit breaker para estado semiaberto.
- Node.js. Classes assíncronas idiomáticas, clientes Redis maduros, modelo de cluster de processos (onde estado compartilhado é obrigatório), bibliotecas de hash consistente e implementações de circuit breaker.
Observabilidade
- Sistema de métricas de séries temporais. Para armazenar indicadores de taxa de sucesso, latência e captchas por endereço e por par endereço-site.
- Dashboards. Visualização da distribuição de estados do pool, matriz endereço-site, frequência de quarentenas. É o dashboard que permitirá, com um olhar, distinguir endereço ruim de site ruim.
- Alertas. Notificação ao se aproximar do limite de quarentena, em caso de falha em massa, quando a taxa de sucesso geral cair abaixo do limite.
O que construir por conta própria
Provavelmente não existirá uma biblioteca universal pronta para pool que atenda a todas as suas nuances — a lógica de negócio das sessões é muito específica. Portanto, o núcleo do pool geralmente é escrito manualmente, apoiando-se nos blocos listados: armazenamento, hashing, métricas, padrão circuit breaker. A boa notícia é que, com uma interface cuidadosa de acquire e release, esse núcleo se torna compacto e reutilizável entre projetos.
Casos e resultados de aplicação
Vamos analisar alguns cenários generalizados que mostram como os princípios do artigo funcionam na prática. Os números são ilustrativos, mas as proporções refletem a dinâmica típica.
Caso um: coleta de dados públicos sem sessões
Tarefa — coleta massiva de informações publicamente acessíveis de páginas independentes. Começou com seleção aleatória ingênua de um arquivo. A taxa de sucesso oscilava em torno de setenta por cento, porque endereços mortos continuavam recebendo tráfego na mesma proporção que os vivos.
Implementaram um pool com seleção ponderada e health-check passivo. O peso do endereço era recalculado pela janela deslizante da taxa de sucesso. Endereços mortos perdiam peso rapidamente e quase paravam de receber tarefas. Adicionaram sondas ativas para endereços ociosos e quarentena exponencial.
Resultado: a taxa de sucesso subiu de cerca de setenta para mais de noventa por cento. O número de tentativas inúteis a endereços mortos caiu várias vezes. Principal conclusão do caso — mesmo sem sessões, apenas o roteamento adaptativo por reputação proporciona um salto notável na eficiência.
Caso dois: trabalho com contas e sticky-sessions
Tarefa — operação estável de múltiplas contas, onde a estabilidade do ambiente de rede de cada uma é crítica. Inicialmente, usava-se seleção aleatória de endereço, e as contas saltavam constantemente entre sub-redes. Resultado — uma enxurrada de solicitações de verificação e aumento na taxa de captchas.
Mudaram para vinculação determinística via hash consistente a partir do identificador da conta, com armazenamento das vinculações no Redis e TTL igual à duração da sessão de negócio. Introduziram a regra rígida: nenhuma rotação no meio da sessão. A vinculação só mudava nos limites.
Resultado: a taxa de captchas nas contas caiu significativamente, o número de solicitações de verificação diminuiu, e o comportamento das contas passou a parecer estável e natural para os sites. Insight do caso — para antifraude, a previsibilidade do ambiente de rede vale mais do que qualquer rotação sofisticada.
Caso três: incidente e proteção contra avalanche de quarentena
Durante a operação do sistema, o site alvo repentinamente endureceu as verificações. Em todos os endereços, captchas começaram a aparecer ao mesmo tempo. O pool, que não tinha limite de quarentena, na primeira versão desse cenário colocou quase todo o pool em quarentena em minutos — o sistema praticamente parou.
Após ajustes, adicionaram três coisas: limite da proporção de endereços em quarentena, reconhecimento de falha em massa como sinal de problema geral e mínimo garantido de endereços em serviço. Quando o incidente se repetiu, o pool reconheceu que as falhas estavam correlacionadas em todos os endereços simultaneamente para um mesmo site, entendeu que a culpa não era dele e não desencadeou uma avalanche. Apenas reduziu os pesos e continuou operando com um mínimo de recursos até a situação se normalizar.
Resultado: em vez de parada total, o sistema sobreviveu ao incidente com degradação, não com falha. Insight — a resiliência se mede pelo comportamento no pior dia, não no melhor.
Caso quatro: diagnóstico de endereço ruim vs. site ruim
Uma equipe, por semanas, periodicamente colocava endereços saudáveis em quarentena sem entender por quê. As métricas eram mantidas apenas por endereço, sem recorte por site. Quando adicionaram a matriz bidimensional endereço-site, a imagem ficou clara instantaneamente: o problema não estava nos endereços, mas em um site específico e instável que gerava picos de erro para todos os endereços simultaneamente.
Configuraram a lógica para que falhas correlacionadas por coluna de site não punissem os endereços. Resultado: o número de quarentenas falsas caiu para quase zero, e a capacidade útil do pool aumentou sem um único novo endereço. Insight — a correta segmentação de métricas às vezes vale mais do que qualquer algoritmo.
Perguntas frequentes
Preciso de um pool se tenho apenas alguns endereços?
Mesmo com um punhado de endereços, o pool se paga assim que aparece qualquer carga ou conceito de sessão. Health-check passivo e quarentena simples protegem você de ficar batendo em um endereço morto. Sticky-binding preserva a estabilidade das contas. Hash consistente completo e armazenamento compartilhado para um par de endereços talvez sejam excessivos, mas um pool básico na memória com interface acquire e release vale a pena praticamente sempre.
Como escolher a duração da sticky-session?
Parta do significado de negócio, não de considerações técnicas. Pergunte: por quanto tempo uma sequência de ações deve ser percebida como uma única visita contínua? Para cenários curtos, são minutos; para trabalho sob um perfil durante um período de atividade, dezenas de minutos ou horas. Defina essa duração como TTL da vinculação e renove-o a cada requisição dentro da sessão, para que o trabalho ativo não seja interrompido no meio.
E se o endereço vinculado morrer no meio da sessão?
Esse é o caso mais desagradável. A regra geral é não rotacionar no meio da sessão. Se o endereço degradou, mas ainda está vivo, continue com ele até o fim da sessão. Se ele morrer completamente, é preferível encerrar ou pausar a sessão corretamente do que transferi-la para outro endereço e criar um efeito de teletransporte. Projete a lógica de negócio de forma que encerrar a sessão seja menos doloroso do que migrá-la.
Com que frequência fazer sondas ativas?
Não sonde endereços saudáveis sob carga — o tráfego vivo fala por eles através do controle passivo. Endereços saudáveis ociosos verifique a cada dezenas de segundos para mantê-los prontos. Endereços em quarentena sonde de acordo com o cronograma de espera exponencial. Sempre distribua as sondas no tempo com jitter para não criar picos síncronos de atividade.
O Redis é obrigatório ou posso usar apenas a memória?
Se você tem estritamente um único processo e está disposto a perder o estado na reinicialização — a memória é aceitável no início. Assim que surge um segundo worker, o armazenamento compartilhado se torna praticamente obrigatório; caso contrário, os processos viverão em realidades diferentes sem coordenação. O Redis é a escolha mais conveniente devido a operações atômicas, estruturas de dados e TTL. Pode começar com memória, mas já abstraia o armazenamento para que a migração para o Redis não reescreva metade do código.
Como distinguir problema de endereço de problema de site alvo?
Mantenha métricas no par endereço-site, não apenas por endereço. Se os erros estão concentrados em um endereço para todos os sites — a culpa é do endereço. Se em todos os endereços para um único site — a culpa é do site, e não se deve punir os endereços. Se em todos os endereços para todos os sites — procure o problema do seu lado: rede, infraestrutura, o próprio sistema de sondas. Essa segmentação bidimensional é a maneira mais confiável de fazer o diagnóstico correto.
O que fazer se quase todo o pool foi para quarentena?
Isso não deveria ser possível com a proteção adequada. Estabeleça um limite para a proporção de endereços em quarentena simultaneamente. Garanta um mínimo de endereços em serviço em qualquer circunstância. Ensine o pool a reconhecer uma falha simultânea em massa como sinal de um problema geral, não de culpa dos endereços. Ao atingir o limite, mude de remoção para quarentena para simples redução de peso — é melhor trabalhar com recursos levemente degradados do que parar completamente.
Qual estratégia de seleção usar por padrão?
Se você não tem sessões e os endereços são homogêneos — comece com round-robin. Se os endereços têm qualidades diferentes — seleção ponderada com peso dinâmico por métricas. Se as tarefas têm durações muito diferentes — least-connections. Se há vinculação a contas ou sessões — hash consistente por chave, e isso não é negociável, porque define a estabilidade do trabalho com contas. Em sistemas complexos, combine estratégias por tipo de tarefa.
Preciso contabilizar captchas separadamente nas métricas?
Sim, absolutamente, e com um limite mais sensível do que para erros comuns. Captcha é um sinal precoce e preciso de queda de reputação do endereço, muitas vezes anterior a recusas diretas. Se você misturar captchas com erros gerais, perderá esse indicador antecedente. Uma métrica separada de taxa de captchas por endereço permitirá reduzir o peso do endereço problemático antes mesmo que ele comece a falhar abertamente.
Como evitar aluguéis travados quando um worker cai?
Não confie apenas na chamada explícita de release. Implemente o aluguel como um registro com TTL ligeiramente superior à duração máxima permitida da tarefa. Se o worker cair e não devolver o endereço, o registro expira sozinho, e o contador de carga ativa se recupera. Além disso, pode-se reconciliar periodicamente os contadores com a realidade. Isso protege o pool de vazamento lento de capacidade devido a aluguéis travados.
Conclusão e próximos passos
Percorremos um longo caminho. Da verdade incômoda sobre por que uma lista de endereços em arquivo de texto se desmancha sob carga real até um sistema de engenharia completo de gerenciamento de endereços dentro da aplicação. Vamos reunir o principal.
O pool não é uma lista, mas um objeto com comportamento, escondido atrás de uma interface simples de acquire e release. A estratégia de seleção de endereço é ditada pela tarefa: round-robin para homogêneos, seleção ponderada para qualidade variada, least-connections para tarefas de durações diferentes e — criticamente importante para trabalhar com contas — hash determinístico, de preferência consistente, por chave. É a previsibilidade do ambiente de rede, e não a aleatoriedade sofisticada, que gera confiança por parte dos sistemas antifraude.
A saúde dos endereços se sustenta em duas pernas: controle passivo pelo tráfego real e sondas ativas. Falha é definida por sinal acumulado, não por erro isolado; o flapping é mitigado por histerese e tempo mínimo de espera. A quarentena se baseia em espera exponencial com jitter, obrigatoriamente limitada por uma proporção máxima de endereços removidos, e protegida contra o desastre de todo o pool acabar no banco de reservas. O estado, com vários workers, vive em um armazenamento compartilhado com operações atômicas e TTL. E a observabilidade no par endereço-site permite distinguir endereço ruim de site ruim — uma habilidade que economiza semanas.
O que fazer agora? Proponho um plano concreto de implementação em etapas.
- Encapsule o trabalho atual com endereços na interface acquire e release, sem mudar nada internamente ainda. Isso prepara o terreno.
- Adicione health-check passivo e quarentena simples na memória. Já aqui você sentirá um aumento na estabilidade.
- Introduza a estratégia de seleção adequada. Se trabalha com contas, já inclua sticky via hash por chave.
- Conecte sondas ativas e espera exponencial com limites de proteção.
- Migre o estado para um armazenamento compartilhado assim que aparecer um segundo worker. Garanta atomicidade e TTL.
- Configure métricas e dashboards, obrigatoriamente com segmentação endereço-site.
- Aprimore a histerese e os limites com base em seus dados reais — aqui não existem números universais, apenas suas observações.
Não tente construir tudo de uma vez. Deixe cada camada amadurecer sob carga, colete métricas, tire conclusões, siga em frente. Um pool de proxies maduro não é uma construção única, mas um sistema vivo que você ajusta à medida que as tarefas crescem. Mas mesmo os primeiros passos deste guia transformarão uma frágil lista de endereços em um suporte confiável para sua aplicação. E isso, convenhamos, vale o esforço.