Pool de proxies dans l'application : sélection d'IP, health-check, quarantaine et sticky-sessions
Sommaire de l'article
- Pourquoi une liste d'adresses dans un fichier texte se désagrège sous charge réelle
- Fondamentaux : pool, location d'adresse pour une tâche et définition d'une session
- Plongée en profondeur : le cycle de vie d'une adresse dans le pool
- Stratégies de sélection d'adresse : du round-robin au hachage par clé
- Health-check : vérifications passives et actives de la santé
- Quarantaine et retour en service : délai, limites et protection du pool
- Stockage de l'état : mémoire du processus vs stockage partagé
- Observabilité : métriques par adresse et comment distinguer une mauvaise ip d'un mauvais site
- Pratique : squelette d'un pool en python et node.js
- Erreurs typiques : ce qu'il ne faut pas faire
- Outils et ressources pour l'implémentation
- Cas concrets et résultats
- Questions fréquentes
- Conclusion et prochaines étapes
Imaginez la scène. Vendredi soir, votre parseur ou votre système de gestion de comptes est enfin lancé en production. Les premières minutes, tout roule. Puis les choses étranges commencent : certaines requêtes échouent, un CAPTCHA apparaît ici, un compte demande soudain une vérification d'identité là, et les logs deviennent un fouillis d'erreurs de connexion. Ça vous parle ? Dans neuf cas sur dix, la racine du problème n'est ni le site cible ni votre logique métier. Elle réside dans la façon dont votre application gère ses adresses IP.
La plupart des projets commencent simplement : un fichier texte avec une liste d'adresses, lecture ligne par ligne, sélection aléatoire. Et ça marche. Jusqu'au moment où la charge devient réelle. Alors la liste naïve s'effondre, et vous obtenez des pannes intermittentes impossibles à reproduire avec une seule requête dans la console.
Cet article est un guide complet pour concevoir un pool de proxies au sein de l'application. Nous allons voir comment sélectionner une adresse pour une tâche spécifique, comment vérifier la santé des adresses, comment mettre les IP problématiques en quarantaine et les réintégrer, et comment maintenir une sticky-session pour un même compte. C'est un sujet d'ingénierie, mais nous en parlerons dans un langage accessible, avec du code, des check-lists et l'analyse d'erreurs réelles.
Fixons tout de suite le cadre. Nous n'abordons pas les timeouts et les politiques de réessai pour une seule requête – c'est un autre vaste sujet. Nous ne traitons pas non plus de la façon dont l'adresse change physiquement sur un modem ou un équipement – c'est un niveau d'infrastructure, pas d'application. Notre focus, c'est la logique du pool dans votre code.
Pourquoi une liste d'adresses dans un fichier texte se désagrège sous charge réelle
Regardons honnêtement une implémentation de départ typique. Un fichier, cent lignes avec des adresses. L'application lit le fichier, met les lignes dans un tableau et, pour chaque requête, prend un élément aléatoire. Simple, compréhensible, ça marche en démo. Pourquoi ça casse ?
Problème numéro un : pas de mémoire de l'état d'une adresse
La sélection aléatoire dans un tableau ne sait rien de ce qui est arrivé à l'adresse une seconde plus tôt. Si l'adresse numéro quarante-sept vient de renvoyer cinq erreurs consécutives et est clairement malade, l'algorithme aléatoire a la même probabilité de la choisir à nouveau. Vous allez frapper encore et encore une adresse morte, perdre du temps, des tentatives et, plus important, la confiance du site cible envers vos actions.
Problème numéro deux : pas de liaison tâche-adresse
Quand vous travaillez avec des comptes, il est essentiel qu'un même compte sorte sur le réseau avec la même adresse. Les systèmes anti-fraude des plateformes remarquent quand la session d'un seul utilisateur saute en quelques minutes sur une dizaine de sous-réseaux de zones géographiques différentes. Ce n'est pas naturel. Un humain ne se comporte pas comme ça. La sélection aléatoire dans un fichier garantit ce chaos.
Problème numéro trois : les conditions de course avec plusieurs workers
Dès que vous lancez plusieurs processus ou threads parallèles, un simple tableau en mémoire devient une source de conditions de course. Deux workers lisent le même index, prennent la même adresse, la chargent deux fois plus fort. Aucune coordination. Les compteurs, s'ils existent, se perdent entre les processus.
Problème numéro quatre : aucune observabilité
Le fichier texte reste muet. Il ne vous dira pas quelle adresse produit quatre-vingts pour cent des CAPTCHA, laquelle est devenue lente, ou laquelle est déjà morte depuis un jour. Vous travaillez en aveugle et ne découvrez les problèmes que par des symptômes indirects dans les métriques métier, quand il est trop tard.
Conclusion simple : une liste d'adresses, ce sont des données. Gérer des adresses sous charge, c'est un système. La différence entre les deux est le sujet de cet article. Nous allons maintenant construire ce système brique par brique.
Fondamentaux : pool, location d'adresse pour une tâche et définition d'une session
Commençons par les bases. Si vous êtes un ingénieur expérimenté, lisez quand même – nous fixons ici la terminologie qui sera utilisée jusqu'à la fin de l'article.
Qu'est-ce qu'un pool d'adresses ?
Un pool n'est pas simplement une liste d'adresses, mais un objet avec un comportement. Il stocke un ensemble d'adresses avec leur état et fournit deux opérations principales : donner une adresse pour une tâche et la récupérer. Analogie classique : une bibliothèque. Vous avez une étagère de livres, mais entre vous et l'étagère se tient un bibliothécaire. Il sait quels livres sont empruntés, lesquels sont endommagés et envoyés en réparation, et lesquels sont disponibles. Vous ne fouillez pas vous-même dans l'étagère – vous demandez au bibliothécaire, et il vous donne un livre adapté.
Location d'une adresse pour une tâche
La location est l'affectation temporaire d'une adresse à une tâche spécifique. Le pool fournit une adresse, la marque comme occupée ou note qu'une nouvelle charge lui est attribuée, et à la fin de la tâche, l'adresse est rendue. C'est pourquoi l'interface du pool comporte deux méthodes qui seront nos chevaux de bataille : acquire – obtenir une adresse, et release – la rendre avec un rapport sur le résultat.
Le rapport lors du rendu est un détail clé. Quand la tâche rend l'adresse, elle indique au pool ce qui s'est passé : succès, erreur de connexion, CAPTCHA, blocage. Cette information alimente toute la logique ultérieure de santé et de quarantaine.
Liaison sticky vs sélection aléatoire
Ici se trouve une frontière cruciale. La sélection aléatoire consiste à donner une adresse différente à chaque requête. Ce mode est bon pour les tâches sans notion de session continue : collecte massive de données publiques sur des pages indépendantes, où chaque requête est autonome.
La liaison sticky consiste à ce qu'une clé donnée (par exemple un identifiant de compte) reçoive toujours la même adresse. C'est essentiel là où la continuité de l'identité dans le temps est importante. Travailler avec un compte en est l'exemple typique. Le compte doit apparaître à la plateforme comme un utilisateur stable et unique, pas comme un essaim d'entités sautant d'une IP à l'autre.
Qu'est-ce qu'une session au niveau de la tâche métier ?
Le mot session est surchargé. Au niveau HTTP, c'est une chose ; au niveau TCP, une autre. Mais ce qui nous intéresse, c'est la session métier. C'est une séquence d'actions logiquement liée qui, du point de vue de la plateforme, doit provenir du même utilisateur avec la même adresse.
Exemples de sessions métier :
- Connexion à un compte, série d'actions à l'intérieur, déconnexion – tout depuis la même adresse.
- Scénario en plusieurs étapes : ouvrir une fiche, ajouter au panier, commander – toutes les étapes sont liées.
- Travailler toute la journée sous un même profil, où un changement d'adresse ressemblerait à un déménagement suspect.
Définir les limites d'une session est une décision de conception, pas une donnée technique. C'est vous qui décidez si une session dure quinze minutes, une heure, ou jusqu'à une déconnexion explicite. Cette définition détermine combien de temps le pool maintient la liaison entre la clé et l'adresse. Retenez-le – nous reviendrons sur les sticky-sessions à plusieurs reprises.
Plongée en profondeur : le cycle de vie d'une adresse dans le pool
Avant d'aborder les stratégies individuelles, il est utile de voir le tableau d'ensemble. Chaque adresse dans un pool bien conçu a un cycle de vie, un ensemble d'états entre lesquels elle transite.
États d'une adresse
- Healthy (saine) – l'adresse est disponible pour attribution, les métriques sont normales.
- Degraded (dégradée) – l'adresse est encore attribuée mais avec un poids réduit car ses performances se sont détériorées.
- Quarantined (en quarantaine) – l'adresse est temporairement exclue de l'attribution, un délai est en cours.
- Probing (en test) – l'adresse subit une vérification active avant de réintégrer le pool.
- Dead (morte) – l'adresse est considérée comme non fonctionnelle pour une longue durée ou définitivement.
Les transitions entre ces états sont précisément le système que nous construisons. Une adresse saine, en accumulant des erreurs, se dégrade. Une adresse dégradée, en atteignant un seuil, passe en quarantaine. De la quarantaine, après un délai, elle va en test. Si le test réussit, elle revient saine. Sinon, elle retourne en quarantaine avec un délai accru. Plusieurs échecs consécutifs, et l'adresse est déclarée morte.
Pourquoi une couche d'abstraction est nécessaire
Insight clé : l'application ne doit pas connaître les états de l'adresse. Le code applicatif se contente de demander une adresse et de la retourner avec un résultat. Toute la complexité du cycle de vie est cachée à l'intérieur du pool. C'est le principe d'encapsulation, et il est payant au centuple. Quand vous voudrez changer la stratégie de quarantaine, vous modifierez un seul module, pas des dizaines d'endroits dans la logique métier.
Modèle mental de la charge
Il est bon de garder en tête trois axes selon lesquels une adresse évolue :
- Fraîcheur – depuis quand avons-nous vérifié sa santé pour la dernière fois.
- Charge – combien de tâches sont actuellement en cours sur elle.
- Réputation – l'historique accumulé des succès et des échecs.
Toute stratégie de sélection combine, en substance, ces trois axes en une évaluation unique. Nous allons maintenant détailler les stratégies concrètes.
Stratégies de sélection d'adresse : du round-robin au hachage par clé
Le cœur du pool est l'algorithme qui décide quelle adresse attribuer lors d'un appel acquire. Il n'y a pas de réponse unique juste. Le choix de la stratégie est dicté par la tâche. Examinons quatre approches de base et expliquons quand chacune est pertinente.
Round-robin : à tour de rôle
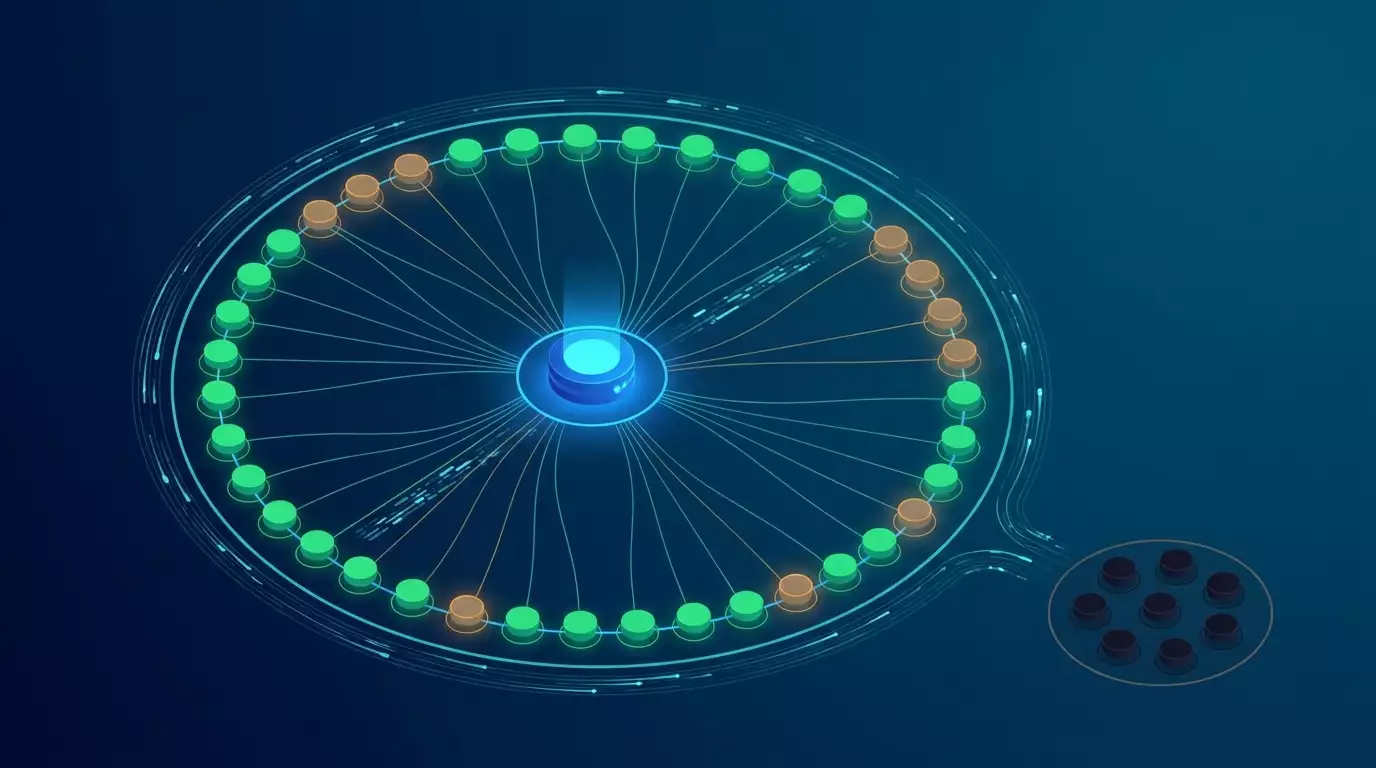
Le round-robin est l'algorithme équitable le plus simple. Les adresses sont disposées en cercle, et un pointeur avance d'un pas à chaque requête. Quand on a fait le tour, on recommence. Avantage : une répartition parfaitement uniforme de la charge si les adresses sont identiques. Inconvénient : l'algorithme est aveugle aux différences entre adresses. Une rapide et une lente reçoivent la même part de trafic.
Quand l'utiliser : pool homogène, tâches sans session, quand toutes les adresses sont à peu près égales en qualité et capacité.
Sélection pondérée
La sélection pondérée est une évolution du round-robin où chaque adresse reçoit un poids. Une adresse avec un poids plus élevé reçoit plus de trafic. On peut définir le poids de manière statique, en fonction de la capacité connue, ou dynamique, en le recalculant à partir de métriques en direct : taux de succès et latence.
Le poids dynamique est un outil puissant. Une adresse commence à renvoyer plus de CAPTCHA ? On réduit son poids, elle reçoit moins de trafic mais n'est pas complètement écartée. Les performances se rétablissent ? Le poids remonte. C'est une autorégulation douce, plus souple qu'une mise en quarantaine brutale.
Formule simple pour le poids : poids = taux de succès divisé par la latence normalisée. Plus le succès est élevé et la latence faible, plus le poids est grand. Recalculez-le sur une fenêtre glissante, par exemple les cinquante dernières requêtes.
Least-connections : le moins chargé
Least-connections attribue l'adresse qui a actuellement le moins de tâches actives. Cela fonctionne à merveille lorsque les tâches varient considérablement en durée. Dans une telle situation, le round-robin peut submerger une adresse avec des tâches longues pendant qu'une autre reste inoccupée. Least-connections équilibre la charge réelle, pas seulement le nombre de requêtes distribuées.
Pour l'implémenter, il faut un compteur de locations actives par adresse. Il augmente lors d'un acquire et diminue lors d'un release. On choisit l'adresse avec le compteur le plus bas. Attention : ce compteur est un état partagé, et avec plusieurs workers, il doit vivre dans un stockage commun. Nous y reviendrons dans la section sur l'état.
Hachage par clé : un seul compte, une seule adresse
Et voici l'essentiel pour travailler avec des comptes. Le hachage par clé est une stratégie où l'adresse n'est pas choisie au hasard, mais de manière déterministe, en fonction d'une clé de tâche. On prend l'identifiant du compte, on calcule son hash, on prend le reste de la division par le nombre d'adresses – on obtient un index. Le même compte donnera toujours le même index, donc la même adresse.
Pourquoi ce n'est pas seulement pratique, mais fondamental ? Voici l'insight clé de tout l'article.
Pourquoi le hachage déterministe est plus important que l'aléatoire pour l'anti-fraude
Les systèmes anti-fraude des plateformes construisent un profil de comportement de l'utilisateur. L'un des signaux de confiance les plus forts est la stabilité de l'environnement réseau. Un humain réel se connecte chaque jour à peu près depuis le même ensemble d'adresses. Son fournisseur d'accès change rarement, sa géographie est stable.
Imaginez maintenant qu'un compte, à chaque action, apparaisse avec une nouvelle adresse d'un sous-réseau différent. Pour le système, cela ressemble à un comportement impossible : un humain ne peut pas être physiquement à dix endroits en une minute. La sélection aléatoire d'adresse garantit de générer exactement ce drapeau rouge.
Le hachage déterministe résout le problème à la racine. Le compte est lié à l'adresse mathématiquement, sans stockage d'état. Même si l'application redémarre et perd toute mémoire, le même compte retrouvera la même adresse. C'est une liaison auto-réparatrice. Élégant, n'est-ce pas ?
Piège : le changement de taille du pool
Le hachage naïf par reste de division a une faiblesse redoutable. Si le nombre d'adresses change – on en ajoute une ou on en met une en quarantaine – alors le reste de la division change pour presque toutes les clés. Pratiquement tous les comptes migrent soudainement vers de nouvelles adresses. C'est exactement la catastrophe que nous essayions d'éviter.
Solution : le hachage cohérent. C'est une technique où l'ajout ou la suppression d'une adresse ne réaffecte qu'une petite fraction des clés, pas toutes. Les adresses et les clés sont placées sur un anneau imaginaire, la clé parcourt l'anneau jusqu'à l'adresse la plus proche. On supprime une adresse ? Seules ses clés bougent, les autres restent en place. C'est le hachage cohérent qui est la base correcte pour une liaison sticky dans un pool vivant où les adresses arrivent et partent.
Combinaison de stratégies
Dans une application réelle, les stratégies sont souvent combinées. Un scénario avancé typique : pour les tâches avec une clé de compte, on utilise le hachage cohérent, et au sein du groupe d'adresses responsables de la réservation, on applique least-connections. Pour la collecte de données sans session, on utilise un round-robin pondéré. Le pool peut contenir plusieurs stratégies et les sélectionner selon le type de tâche.
Check-list pour choisir une stratégie
- Y a-t-il une notion de session ou de liaison à un compte ? Utilisez le hachage par clé, de préférence cohérent.
- Les tâches sont indépendantes et homogènes ? Round-robin.
- Les adresses sont de qualité différente ? Sélection pondérée avec poids dynamique.
- Les tâches ont des durées très variables ? Least-connections.
- Charge mixte ? Combinaison avec subdivision du pool en sous-groupes.
Health-check : vérifications passives et actives de la santé
Un pool ne vaut que par la connaissance qu'il a de l'état de ses adresses. D'où le mécanisme de vérification de santé, le health-check. Il existe deux approches complémentaires : passive et active. Les deux sont nécessaires.
Health-check passif par les erreurs du trafic
La vérification passive n'effectue pas de requêtes séparées. Elle observe le trafic réel qui passe de toute façon par l'adresse. Chaque appel release apporte un résultat, et le pool met à jour la réputation de l'adresse en conséquence. C'est gratuit – vous avez déjà fait la requête pour de bon, vous en tenez simplement compte.
Quels signaux d'aggravation dans l'observation passive :
- Erreurs de connexion : l'adresse ne répond pas, rupture de lien.
- Réponses typiques d'un blocage au niveau réseau.
- Pic de CAPTCHA – indirect mais important signal de baisse de réputation.
- Hausse brutale de la latence par rapport à la normale historique de l'adresse.
Avantage de l'approche passive : actualité et aucune charge supplémentaire. Inconvénient : elle ne réagit que lorsque le trafic a déjà eu lieu, donc les premières requêtes impactées sont inévitables. Et elle ne sait rien des adresses qui sont actuellement inactives.
Health-check actif via des sondes
La vérification active est une sonde distincte que le pool lance lui-même, indépendamment du trafic de travail. Généralement, c'est une requête légère vers une ressource de contrôle connue, qui répond de manière fiable et permet de juger de l'état de fonctionnement de l'adresse.
Les sondes actives résolvent ce que la passive ne peut pas : vérifier les adresses inactives et celles en quarantaine avant de les réintégrer. C'est la sonde active qui fait office de barrière décidant si une adresse peut sortir de quarantaine et revenir en service.
Qu'est-ce qu'un échec de vérification ?
Définir un échec est un point délicat. Trop strict, et vous exclurez des adresses normales à cause d'un pic aléatoire. Trop souple, et des adresses mortes resteront dans le pool. Une approche raisonnable est un seuil multifactoriel.
- Une erreur unique n'est pas un échec. C'est du bruit. Le réseau est peu fiable par nature.
- Un échec est un signal cumulé : par exemple, trois erreurs sur les cinq dernières requêtes, ou un taux de succès sur la fenêtre tombé en dessous de soixante-dix pour cent.
- Le taux de CAPTCHA doit être traité à part. Le seuil est ici plus bas, car un CAPTCHA est un signal de réputation de l'adresse, pas une panne aléatoire.
Quels intervalles choisir ?
Les intervalles des sondes actives sont une question d'équilibre entre fraîcheur des données et charge inutile. Repères généraux :
- Les adresses saines sous charge n'ont pas besoin d'être sondées activement – le trafic passif parle pour elles.
- Adresses saines inactives : une sonde toutes les trente à soixante secondes pour les maintenir prêtes.
- Adresses en quarantaine : sonde selon le calendrier du délai, voir plus bas.
- Ne sondez pas toutes les adresses en même temps. Étalez les sondes dans le temps, ajoutez un décalage aléatoire pour éviter les pics synchrones.
Le flapping et comment l'amortir avec l'hystérésis
Voici l'un des phénomènes les plus sous-estimés. Le flapping est le moment où une adresse oscille rapidement entre les états sain et malade. La sonde réussit – on la réintègre. Aussitôt une erreur – on l'exclut. Une seconde plus tard, la sonde réussit à nouveau – on la réintègre. Et ainsi de suite. Cela épuise le système, crée des à-coups dans les métriques et ne permet à l'adresse ni de fonctionner ni de se reposer.
Le remède est l'hystérésis. Terme issu de l'électronique, signifiant des seuils différents pour entrer et sortir d'un état. L'idée est simple : il faut moins de signaux pour déclarer une adresse malade que pour la déclarer à nouveau saine. Par exemple, trois erreurs consécutives la mettent en quarantaine, mais pour revenir, il faut cinq sondes réussies consécutives. L'asymétrie des seuils crée une zone de stabilité où les petites fluctuations ne changent pas d'état.
Deuxième outil contre le flapping : le temps de maintien dans l'état. Une adresse entrée en quarantaine doit y rester un temps minimum, même si la sonde réussit avant. Cela amortit les oscillations rapides. La combinaison de l'hystérésis et du temps de maintien transforme un système nerveux en un système calme et prévisible.
Check-list health-check
- Les deux types de vérifications fonctionnent : passive via le trafic et active via des sondes.
- L'échec est défini comme un signal cumulé, pas une erreur unique.
- Un seuil distinct et plus sensible est défini pour le taux de CAPTCHA.
- Les sondes actives sont étalées dans le temps avec un décalage aléatoire.
- L'hystérésis est configurée : seuil d'entrée en problème inférieur au seuil de sortie.
- Un temps de maintien minimal dans l'état est défini pour contrer le flapping.
Quarantaine et retour en service : délai, limites et protection du pool
Lorsqu'une adresse est déclarée problématique, on ne peut pas simplement la jeter. Souvent, le problème est temporaire. Le rôle de la quarantaine est de laisser l'adresse se reposer, puis de vérifier si elle s'est rétablie. Il y a beaucoup d'ingénierie subtile ici.
Délai exponentiel
Une quarantaine naïve maintient l'adresse pendant un temps fixe, disons une minute, puis la réintègre. Mais si l'adresse est durablement problématique, vous la réintégrerez sans cesse, recevant à chaque fois une nouvelle série d'échecs. La solution est le délai exponentiel.
Principe : à chaque entrée successive en quarantaine, le temps de délai augmente. Première fois : une minute. Deuxième fois consécutive : deux minutes. Puis quatre, huit, seize. Jusqu'à un plafond raisonnable, par exemple une heure. Dès que l'adresse fonctionne avec succès suffisamment longtemps, le compteur de délai est remis à zéro.
Cela résout élégamment deux problèmes à la fois. Une adresse qui a trébuché temporairement revient rapidement. Une adresse durablement malade alertera le système de moins en moins souvent, jusqu'à devenir pratiquement morte, sans encombrer le pool de sondes inutiles fréquentes.
Ajoutez au délai une dispersion aléatoire, appelée jitter. Sans cela, toutes les adresses entrées en quarantaine au même moment reviendront en même temps, en une salve. Le jitter étale les retours dans le temps.
Limite du nombre d'adresses simultanément en quarantaine
Voici une protection cruciale que l'on oublie le plus souvent. Que se passe-t-il si un incident touche soudainement la moitié des adresses ? Par exemple, la plateforme cible a renforcé ses contrôles. Le pool va honnêtement mettre les adresses en quarantaine une par une. Et si aucune limite n'est fixée, vous vous retrouverez avec presque plus personne en service.
D'où la règle : une limite stricte sur la proportion d'adresses simultanément en quarantaine. Par exemple, pas plus de trente pour cent du pool. Si la limite est atteinte, les nouveaux candidats à la quarantaine ne sont pas exclus, mais seulement réduits en poids. La logique : mieux vaut travailler avec des adresses légèrement dégradées que de se retrouver complètement sans ressources.
Protection contre le scénario où tout le pool est en quarantaine
C'est la suite de la réflexion précédente, poussée jusqu'au cas extrême. Imaginez : la sonde vers la ressource de contrôle elle-même est cassée. La ressource est tombée ou a changé de réponse. Le pool décide que toutes les adresses sont mortes et met tout le pool en quarantaine. L'application s'arrête net, alors que les adresses sont en réalité en bon état.
Mécanismes de protection :
- Minimum garanti en service. Gardez toujours au moins une ou deux adresses disponibles, même si formellement elles n'ont pas passé la vérification. Mieux vaut qu'elles travaillent sous suspicion que le système s'arrête.
- Analyse de corrélation. Si les échecs arrivent simultanément sur toutes les adresses, c'est suspect. C'est probablement un facteur commun qui est cassé : la sonde, le réseau de votre côté, la ressource cible. Le pool doit être capable de reconnaître un échec massif et ne pas paniquer en excluant tout le monde.
- Ressources de contrôle séparées. Ne faites pas dépendre la sonde active d'un seul point de contrôle. Si celui-ci devient votre point de défaillance unique, de faux positifs feront s'effondrer tout le pool.
Retour en service via l'état semi-ouvert
Le retour de quarantaine n'est pas instantané. Une bonne pratique est l'état semi-ouvert, une idée issue du pattern du coupe-circuit. Une adresse sortant de quarantaine ne reçoit pas tout de suite tout le trafic. D'abord, on lui donne une minuscule part, un filet d'essai. Si les requêtes d'essai réussissent, on augmente progressivement la part jusqu'à ce que l'adresse atteigne son plein poids. Si les essais échouent, retour en quarantaine avec un délai accru.
Cette montée en charge progressive protège contre une salve prématurée de trafic sur une adresse pas encore complètement rétablie.
Check-list quarantaine
- Le délai augmente de manière exponentielle en cas de retour en quarantaine.
- Du jitter est ajouté au délai pour éviter les retours synchrones.
- Une limite est fixée sur la proportion d'adresses en quarantaine simultanément.
- Un minimum d'adresses est garanti en service quelles que soient les conditions.
- Il existe une reconnaissance des échecs massifs comme signe d'un problème général.
- Le retour se fait via un état semi-ouvert avec une montée en charge progressive.
Stockage de l'état : mémoire du processus vs stockage partagé
Toute la logique que nous avons abordée – compteurs de charge, réputation, états de quarantaine – ce sont des données qui doivent vivre quelque part. Où exactement est une décision architecturale déterminante. Elle dépend du nombre de processus que vous avez.
Mémoire du processus : simple, mais solitaire
Si l'application fonctionne en un seul processus, l'état du pool est plus simple à conserver en mémoire. Des structures de données classiques : dictionnaire d'adresses, leurs compteurs et minuteries. Rapide, aucune dépendance, aucun délai réseau.
Les inconvénients sont évidents. Un redémarrage – et tout l'historique est perdu, le pool repart de zéro, oubliant qui était en quarantaine. Et surtout, cela ne fonctionne pas dès qu'il y a plus d'un processus. Chaque processus aura sa propre vue isolée du monde. L'un met une adresse en quarantaine, l'autre l'ignore et continue de la charger.
Stockage partagé : Redis et Memcached
Dès que vous avez plusieurs workers – et sous charge réelle, vous en avez presque toujours – l'état doit devenir partagé. C'est là qu'entrent en scène des stockages rapides comme Redis ou Memcached. Ils vivent comme un service séparé auquel tous les workers accèdent, fournissant une vue cohérente et unifiée de l'état du pool.
Redis est préférable à Memcached dans la plupart des cas, car il offre des opérations atomiques, des structures de données comme les ensembles triés et les hachages, des compteurs avec incrémentation atomique et la possibilité d'exécuter de petits scripts de manière atomique. Tout cela nous sera utile.
Conditions de course avec plusieurs workers
Le stockage partagé résout le problème de visibilité, mais en crée un nouveau : les conditions de course. Scénario classique du least-connections : deux workers lisent les compteurs en même temps, voient tous deux que l'adresse X est la moins chargée, la choisissent tous les deux, et incrémentent tous les deux le compteur. Résultat : l'adresse reçoit une double charge, alors que l'algorithme devait l'éviter.
Solutions :
- Opérations atomiques. L'incrémentation d'un compteur dans Redis est atomique par nature. Utilisez-la au lieu de lire, incrémenter et écrire séparément.
- Scripts. Une logique de sélection complexe, qui nécessite de lire plusieurs valeurs et de prendre une décision, peut être encapsulée dans un seul script atomique côté stockage. Ainsi, personne ne peut s'intercaler entre la lecture et l'écriture.
- Verrous distribués. Pour les sections critiques, on peut prendre un verrou court. Mais attention : les verrous nuisent aux performances et peuvent eux-mêmes devenir une source de problèmes. Les opérations atomiques sont presque toujours meilleures.
TTL des enregistrements
Un outil essentiel dans le stockage partagé est le TTL, la durée de vie d'un enregistrement après laquelle il disparaît automatiquement. Il évite l'accumulation de déchets et le blocage des états.
Où appliquer le TTL :
- Liaison sticky clé-adresse. Vous vous souvenez de la session métier ? Sa durée est précisément le TTL de l'enregistrement de liaison. Fixez un TTL de quinze minutes – et après quinze minutes d'inactivité, la liaison se dissout d'elle-même, le compte pourra obtenir une nouvelle liaison lors de sa prochaine demande. C'est une manière propre et élégante d'exprimer la durée de vie de la session.
- Compteur de locations actives. Si un worker tombe sans appeler release, le compteur risque de rester bloqué à une valeur trop élevée. Un TTL ou une vérification périodique protège contre cela. Souvent, la location est créée comme un enregistrement avec un TTL légèrement supérieur à la durée maximale de la tâche, afin qu'un worker bloqué ne conserve pas l'adresse indéfiniment.
- État de quarantaine. Le temps de délai lui-même s'exprime naturellement via un TTL : l'enregistrement de quarantaine vit exactement aussi longtemps que le délai, et à son expiration, il disparaît, ouvrant la voie au retour.
Approche hybride
Dans la pratique, on utilise souvent une approche hybride. Les données chaudes, fréquemment lues, sont mises en cache localement dans la mémoire du worker pour une courte durée, tandis que la source de vérité reste le stockage partagé. Cela réduit le nombre d'accès à Redis, mais nécessite de la rigueur pour éviter la désynchronisation. Un bon compromis est un cache local avec un TTL très court, par exemple une ou deux secondes, pour les métriques qui ne nécessitent pas une précision instantanée.
Observabilité : métriques par adresse et comment distinguer une mauvaise IP d'un mauvais site
On ne peut pas gérer ce que l'on ne mesure pas. L'observabilité transforme le pool d'une boîte noire en un système transparent où vous voyez la santé de chaque adresse et comprenez les causes des problèmes.
Métriques par adresse
Le minimum à suivre pour chaque adresse sur une fenêtre glissante :
- Taux de succès. Rapport entre les fins réussies et le nombre total de tâches. Indicateur intégral principal de la santé.
- Latence. Ne vous contentez pas de la moyenne, suivez aussi les centiles. La médiane et, disons, le quatre-vingt-quinzième centile en diront bien plus sur les queues que la moyenne, facilement faussée par les valeurs aberrantes.
- Taux de CAPTCHA. Une métrique séparée et très parlante. Une augmentation du taux de CAPTCHA sur une adresse est un signal précoce de baisse de réputation, souvent avant même que les erreurs directes n'augmentent.
- Nombre de locations actives. La charge actuelle, nécessaire pour le least-connections et pour comprendre la répartition.
- Historique des quarantaines. Combien de fois et pendant combien de temps l'adresse a été mise en quarantaine. Les récidivistes sont immédiatement visibles.
Métriques globales du pool
- Proportion d'adresses dans chaque état : saines, dégradées, en quarantaine, mortes.
- Capacité globale et taux de succès agrégé.
- Fréquence des entrées en quarantaine dans le temps – un pic signale un incident.
- Taux d'occupation de la limite de quarantaine – s'en approcher est un signe d'alarme.
Comment distinguer une mauvaise IP d'un mauvais site
Voici la question qui sépare un système mature d'un système naïf. Les erreurs pleuvent – mais qui est coupable ? L'adresse problématique ou le site cible lui-même, momentanément inaccessible pour tout le monde ? Si vous confondez, vous commencerez à mettre en quarantaine des adresses saines pour les péchés d'un serveur distant.
Méthode pour séparer les diagnostics : l'analyse de corrélation :
- Problème sur une seule adresse. Si les erreurs et les CAPTCHA sont concentrés sur une ou quelques adresses alors que les autres fonctionnent normalement – c'est l'adresse qui est en cause. Quarantaine.
- Problème sur toutes les adresses vers un même site. Si, pour toutes les adresses, le taux de succès chute brutalement spécifiquement vers un site cible, alors que les autres sites vont bien – ce n'est pas le pool le problème, c'est ce site. Mettre les adresses en quarantaine est inutile et nuisible.
- Problème sur toutes les adresses vers tous les sites. Le problème est probablement de votre côté : réseau, infrastructure, le système de sondes lui-même. Là encore, il ne faut pas accuser les adresses.
Conclusion pratique : découpez les métriques non seulement par adresse, mais aussi par couple adresse-site. Ainsi, une matrice de succès montrera immédiatement où une ligne entière est rouge – c'est l'adresse qui est en cause, et où une colonne entière est rouge – c'est le site. Cette représentation bidimensionnelle simple économise des heures de débogage et sauve le pool de l'autodestruction pour rien.
Logs et traçage
En plus des métriques agrégées, il est utile de journaliser les décisions du pool : pourquoi telle adresse a été choisie, pourquoi telle autre a été mise en quarantaine. Quand quelque chose tournera mal, ces traces de décisions seront votre bouée de sauvetage. Ne journalisez pas chaque requête en détail – vous vous noieriez. Journalisez les transitions d'état et les décisions atypiques.
Pratique : squelette d'un pool en Python et Node.js
Passons de la théorie au code. Examinons les morceaux clés d'une implémentation sur deux plateformes populaires. Ce sont des squelettes, des structures sur lesquelles vous ajouterez la spécificité de votre projet. Nous omettons les détails pour la clarté des idées principales : l'interface acquire et release, la sélection d'adresse et la prise en compte du résultat.
Interface : acquire et release
Convenons d'un contrat. La méthode acquire prend une clé optionnelle – par exemple un identifiant de compte pour la liaison sticky – et renvoie une adresse. La méthode release prend une adresse et le résultat de la tâche. Le résultat décrit minimalement deux faits : y a-t-il eu un succès, et y a-t-il eu un signe de CAPTCHA ou de blocage.
Squelette en Python
Considérons un pool simplifié en Python. Nous gardons la logique en mémoire pour plus de clarté, mais nous indiquons où connecter le stockage partagé.
Les éléments clés de la structure de données : un dictionnaire dont la clé est l'adresse, la valeur est un objet d'état avec des champs de réputation, le nombre de locations actives, l'horodatage de sortie de quarantaine et la durée actuelle du délai. Séparément, on stocke une table de liaisons sticky clé-adresse.
Le pseudo-code de la méthode acquire dans un langage ressemblant à Python ressemble à ceci. D'abord, on vérifie s'il y a une clé. Si une clé est fournie et qu'il existe une liaison active et que l'adresse liée est saine – on la retourne, en prolongeant la durée de vie de la liaison. Si la liaison n'existe pas – on sélectionne une adresse via un hachage cohérent de la clé parmi les adresses saines, on enregistre la liaison avec un TTL, on retourne l'adresse. S'il n'y a pas de clé du tout – on applique la stratégie pour les tâches sans session, par exemple une sélection pondérée parmi les saines. Dans tous les cas, on incrémente le compteur de locations actives de l'adresse choisie.
Pseudo-code de release : décrémenter le compteur de locations actives. Mettre à jour la fenêtre glissante de réputation selon le résultat – ajouter un succès ou un échec, prendre en compte séparément le signe de CAPTCHA. Si les signaux cumulés ont franchi le seuil d'échec en tenant compte de l'hystérésis – mettre l'adresse en quarantaine : marquer l'état, calculer le temps de délai comme le délai de base multiplié par deux à la puissance du nombre de récidives, limité par un plafond, ajouter du jitter, définir un TTL ou un horodatage de retour. Si le résultat est bon et que l'adresse est stable depuis longtemps – réinitialiser le compteur de récidives de quarantaine.
Une boucle de fond séparée, à intervalles réguliers, parcourt les adresses en quarantaine dont le délai a expiré et lance une sonde active. Si la sonde réussit le nombre requis de fois en tenant compte de l'hystérésis – l'adresse passe en état semi-ouvert avec un petit poids, puis progressivement en état sain. Si elle échoue – prolonger la quarantaine avec un délai accru.
Détails pratiques importants pour l'implémentation Python : utilisez l'asynchrone si vous avez beaucoup de tâches parallèles, enveloppez l'accès aux structures partagées avec une synchronisation appropriée, et lorsque vous passez à plusieurs processus, remplacez les dictionnaires internes par des appels à Redis via des commandes atomiques et des scripts. Le compteur de locations actives se prête parfaitement à l'incrémentation atomique, la liaison clé-adresse à un enregistrement avec TTL, et l'ensemble des adresses par état est pratique à gérer dans des ensembles triés où le poids de l'adresse est son score.
Squelette en Node.js
Dans Node.js, le modèle asynchrone est naturel, et le pool est généralement conçu comme une classe avec des méthodes asynchrones acquire et release qui retournent des promesses. L'idée est la même, l'idiomatique change.
La structure d'état – un dictionnaire d'adresses, où la valeur contient la réputation comme un buffer circulaire des derniers résultats, le compteur de locations actives et les champs de quarantaine. Pour plusieurs workers, et dans Node cela arrive souvent via un cluster de processus, l'état est également externalisé dans Redis, car chaque processus est isolé.
Méthode acquire en Node : vérifier de manière asynchrone la liaison sticky via le stockage. Si une liaison existe et est saine – retourner et prolonger le TTL. Sinon, sélectionner une adresse – pour une clé via hachage cohérent, pour une tâche sans session via pondération. Incrémenter atomiquement le compteur de locations. Retourner l'adresse.
Méthode release en Node : décrémenter atomiquement le compteur. Enregistrer le résultat dans la fenêtre de réputation. Vérifier les seuils avec hystérésis et, en cas d'échec, mettre en quarantaine avec délai exponentiel et jitter, tout en respectant la limite du nombre total d'adresses en quarantaine – si la limite est atteinte, réduire le poids au lieu de mettre en quarantaine.
La vérification de fond en Node est facilement implémentée via un timer périodique qui sélectionne les adresses dont le délai a expiré et lance des sondes actives, en les étalant dans le temps. Les sondes réussies ramènent progressivement l'adresse en augmentant son poids par étapes.
Conseil général pour les deux plateformes : n'essayez pas de faire parfait du premier coup. Commencez par un round-robin avec un health-check passif et une quarantaine simple en mémoire. Assurez-vous que l'interface acquire et release est pratique pour votre logique métier. Ensuite, ajoutez progressivement le sticky via le hachage, les sondes actives, le stockage partagé, les limites et l'observabilité. Laissez chaque couche mûrir sous charge réelle.
Mini-check-list d'implémentation
- L'interface se résume à acquire avec une clé optionnelle et release avec un résultat.
- Toute la complexité des états est cachée à l'intérieur du pool, le code métier n'en sait rien.
- Le sticky est implémenté via un hachage déterministe, de préférence cohérent.
- Les compteurs et les liaisons sont atomiques en présence de plusieurs workers.
- Il existe une boucle de fond pour les sondes actives de la quarantaine et des adresses inactives.
- Les métriques sont écrites à chaque release.
Erreurs typiques : ce qu'il ne faut pas faire
La théorie est acquise, le squelette est construit. Passons maintenant en revue les râteaux sur lesquels on marche encore et encore. Connaître ces erreurs vous fera gagner des semaines de débogage.
Pool unique pour différents sites
Il est tentant de créer un seul grand pool et d'y faire passer tout le trafic vers tous les sites cibles à la fois. Ne faites pas cela sans réflexion. La réputation d'une adresse varie selon les sites. Une adresse qui fonctionne parfaitement avec l'un peut être bloquée sur un autre. Si vous mélangez tout dans un seul pool et une seule statistique, vous obtiendrez une image floue où une bonne adresse pour une tâche sera injustement punie pour les problèmes d'une autre.
La bonne pratique : suivez la réputation par couple adresse-site, et séparez logiquement les pools ou sous-groupes par direction. Ainsi, la décision de quarantaine est prise ponctuellement et de manière juste.
Absence de limite de tâches par adresse
Même une adresse saine a une limite. Si le pool attribue joyeusement des centaines de tâches simultanées à une adresse populaire, vous créez vous-même une anomalie : une concentration d'activité anormalement élevée depuis un point unique. Cela surcharge l'adresse et semble suspect pour la plateforme.
Introduisez un plafond pour le nombre de locations simultanées par adresse. Une fois le plafond atteint, l'adresse est temporairement exclue des candidates, le trafic va vers d'autres. Cette simple limitation protège de nombreux problèmes.
Rotation en milieu de session
Péché capital quand on travaille avec des comptes. Un compte a commencé une action avec une adresse, et à cause d'une mise en quarantaine ou d'un changement de taille du pool, il se retrouve soudain sur une autre adresse en milieu de session. Du point de vue de la plateforme, l'utilisateur s'est téléporté. C'est l'un des signes les plus évidents d'automatisation.
Protection : tant qu'une session active est en cours, la liaison clé-adresse doit être intouchable, même si l'adresse s'est un peu dégradée. Ne changez la liaison qu'aux limites de la session – à sa fin naturelle ou à l'expiration du TTL. Et si l'adresse meurt complètement et qu'il n'y a pas d'autre choix, il vaut mieux terminer la session proprement que de la basculer sur une autre adresse en cours de route.
Autres erreurs fréquentes
- Une erreur unique comme verdict. Mettre une adresse en quarantaine pour une seule panne aléatoire. Le réseau n'est pas fiable, un raté isolé est normal. Seul un signal cumulé compte.
- Absence d'hystérésis. Entraîne le flapping et les à-coups dont nous avons parlé.
- Délai fixe au lieu d'exponentiel. Une adresse durablement malade reviendra sans cesse et gâchera les statistiques.
- Pas de limite de quarantaine. Un incident peut mettre tout le pool en quarantaine et arrêter le système.
- Sondes synchrones. Toutes les adresses sont sondées en même temps, créant des pics de charge.
- État uniquement en mémoire avec plusieurs workers. Chaque processus vit dans sa propre réalité, aucune coordination.
- Locations bloquées. Release n'est pas appelé à cause d'un plantage, le compteur reste bloqué trop haut, l'adresse est considérée comme éternellement occupée. Solution : TTL sur la location.
- Confiance aveugle en une seule ressource de contrôle. Elle tombe – et tout le pool se croit mort.
Outils et ressources pour l'implémentation
Rassemblons l'arsenal pratique. Ce qui sera vraiment utile pour construire le pool.
Stockage d'état
- Redis. Le choix principal pour l'état partagé. Compteurs atomiques, ensembles triés pour les poids et les états, hachages pour les métadonnées des adresses, TTL intégré, scripts pour une logique complexe atomique. Pratiquement idéal pour notre tâche.
- Memcached. Plus simple et plus léger, convient si vous n'avez besoin que de caches de base avec des compteurs, mais perd face à Redis en richesse de structures et en atomicité des opérations complexes.
Bibliothèques et approches par écosystème
- Python. Stack asynchrone pour les tâches parallèles, client Redis avec support asynchrone et scripts, implémentations prêtes du hachage cohérent, et le pattern du coupe-circuit pour l'état semi-ouvert.
- Node.js. Classes asynchrones idiomatiques, clients Redis matures, modèle de cluster de processus où l'état partagé est obligatoire, bibliothèques de hachage cohérent et implémentations de circuit breaker.
Observabilité
- Système de métriques de séries temporelles. Pour stocker les indicateurs de taux de succès, latence et CAPTCHA par adresse et par couple adresse-site.
- Tableaux de bord. Visualisation de la répartition des états du pool, matrice adresse-site, fréquence des quarantaines. C'est le tableau de bord qui permettra d'un coup d'œil de distinguer une mauvaise adresse d'un mauvais site.
- Alertes. Notification à l'approche de la limite de quarantaine, en cas d'échec massif, en cas de baisse du taux de succès global en dessous d'un seuil.
Que construire soi-même
Il n'existe probablement pas de bibliothèque universelle prête à l'emploi pour un pool qui couvre toutes vos spécificités – la logique métier des sessions est trop particulière. Par conséquent, le cœur du pool est généralement écrit sur mesure, en s'appuyant sur les briques énumérées : stockage, hachage, métriques, pattern du coupe-circuit. La bonne nouvelle, c'est qu'avec une interface soignée acquire et release, ce cœur s'avère compact et réutilisable entre projets.
Cas concrets et résultats
Analysons quelques scénarios généralisés montrant comment les principes de l'article fonctionnent en pratique. Les chiffres sont illustratifs, mais les proportions reflètent une dynamique typique.
Cas numéro un : collecte de données publiques sans sessions
Mission : collecte massive d'informations publiques sur des pages indépendantes. Au début, sélection aléatoire naïve dans un fichier. Le taux de succès oscillait autour de soixante-dix pour cent, car les adresses mortes continuaient à recevoir du trafic au même titre que les vivantes.
Mise en place d'un pool avec sélection pondérée et health-check passif. Le poids de l'adresse était recalculé sur une fenêtre glissante du taux de succès. Les adresses mortes perdaient rapidement du poids et ne recevaient presque plus de tâches. Ajout de sondes actives pour les adresses inactives et quarantaine exponentielle.
Résultat : le taux de succès est passé d'environ soixante-dix à plus de quatre-vingt-dix pour cent. Le nombre de tentatives inutiles vers des adresses mortes a été multiplié par plusieurs. Leçon principale de ce cas : même sans sessions, le simple routage adaptatif basé sur la réputation donne un bond notable d'efficacité.
Cas numéro deux : travail avec des comptes et sticky-sessions
Mission : fonctionnement stable d'une multitude de comptes où la stabilité de l'environnement réseau de chacun est critique. Initialement, sélection aléatoire d'adresse, les comptes sautaient constamment entre sous-réseaux. Résultat : une avalanche de demandes de vérification et une augmentation du taux de CAPTCHA.
Transition vers une liaison déterministe via hachage cohérent de l'identifiant du compte, avec stockage des liaisons dans Redis et un TTL égal à la durée de la session métier. Introduction d'une règle stricte : aucune rotation en milieu de session. La liaison ne changeait qu'aux limites.
Résultat : le taux de CAPTCHA sur les comptes a nettement baissé, le nombre de demandes de vérification a chuté, le comportement des comptes est devenu stable et naturel aux yeux des plateformes. Leçon : pour l'anti-fraude, la prévisibilité de l'environnement réseau est plus précieuse que n'importe quelle rotation sophistiquée.
Cas numéro trois : incident et protection contre l'avalanche de quarantaine
Pendant que le système fonctionnait, la plateforme cible a soudainement renforcé ses contrôles. Les CAPTCHA ont plu sur toutes les adresses en même temps. Le pool, qui n'avait pas de limite de quarantaine, dans une première version de ce scénario, a mis presque tout le pool en quarantaine en quelques minutes – le système s'est pratiquement arrêté.
Après correction, trois choses ont été ajoutées : une limite de la proportion d'adresses en quarantaine, une reconnaissance des échecs massifs comme signe d'un problème général, et un minimum garanti d'adresses en service. Lors de la répétition de l'incident, le pool a reconnu que les échecs étaient corrélés sur toutes les adresses simultanément vers un même site, a compris que ce n'était pas de sa faute et n'a pas provoqué d'avalanche. Il a simplement réduit les poids et a continué à fonctionner avec un minimum de ressources jusqu'à ce que la situation se normalise.
Résultat : au lieu d'un arrêt complet, le système a traversé l'incident avec une dégradation, pas une panne. Leçon : la résilience se mesure par le comportement lors du pire jour, pas du meilleur.
Cas numéro quatre : diagnostic – mauvaise adresse contre mauvais site
Une équipe mettait périodiquement en quarantaine des adresses saines pendant des semaines sans comprendre pourquoi. Les métriques n'étaient suivies que par adresse, sans découpage par site. Lorsqu'on a ajouté une matrice bidimensionnelle adresse-site, l'image s'est éclaircie instantanément : le problème ne venait pas des adresses, mais d'un site capricieux qui produisait des pics d'erreurs pour toutes les adresses en même temps.
La logique a été configurée pour que les échecs corrélés par colonne de site ne pénalisent pas les adresses. Résultat : le nombre de fausses quarantaines est tombé à presque zéro, et la capacité utile du pool a augmenté sans ajouter une seule nouvelle adresse. Leçon : une bonne découpe des métriques vaut parfois plus que tous les algorithmes.
Questions fréquentes
Un pool est-il nécessaire si je n'ai que quelques adresses ?
Même avec une poignée d'adresses, le pool est rentable dès qu'il y a un tant soit peu de charge ou de notion de session. Le health-check passif et la quarantaine simple vous protégeront contre le martèlement d'une adresse morte. La liaison sticky préservera la stabilité des comptes. Le hachage cohérent complet et le stockage partagé pour deux adresses sont peut-être excessifs, mais un pool de base en mémoire avec l'interface acquire et release vaut le coup dans presque tous les cas.
Comment choisir la durée d'une sticky-session ?
Partez du sens métier, pas de considérations techniques. Demandez-vous : combien de temps une séquence d'actions doit-elle être perçue comme une seule visite continue ? Pour des scénarios courts, ce sont des minutes ; pour un travail sous profil pendant une période d'activité, des dizaines de minutes ou des heures. Fixez cette durée comme TTL de la liaison et prolongez-la à chaque interaction dans le cadre de la session, pour qu'un travail actif ne soit pas interrompu en plein milieu.
Que faire si l'adresse liée meurt en milieu de session ?
C'est le cas le plus désagréable. La règle générale : ne pas faire de rotation en milieu de session. Si l'adresse est dégradée mais encore vivante, continuez avec elle jusqu'à la fin de la session. Si elle meurt complètement, il est préférable de terminer ou de mettre en pause la session proprement plutôt que de la basculer sur une autre adresse et de créer un effet de téléportation. Concevez votre logique métier de sorte que la fin d'une session soit moins douloureuse que sa migration.
À quelle fréquence faire des sondes actives ?
Ne sondez pas les adresses saines sous charge – le trafic passif parle pour elles. Les adresses saines inactives, vérifiez-les toutes les quelques dizaines de secondes pour les maintenir prêtes. Les adresses en quarantaine, sondez-les selon le calendrier du délai exponentiel. Étalez impérativement les sondes dans le temps avec du jitter pour éviter des pics d'activité synchrones.
Redis est-il obligatoire ou puis-je me contenter de la mémoire ?
Si vous avez strictement un seul processus et que vous acceptez de perdre l'état au redémarrage, la mémoire est acceptable au début. Dès qu'un deuxième worker apparaît, le stockage partagé devient pratiquement obligatoire, sinon les processus vivront dans des réalités différentes sans coordination. Redis est le choix le plus pratique en raison de ses opérations atomiques, de ses structures de données et de son TTL. Vous pouvez commencer avec la mémoire, mais prévoyez une abstraction du stockage pour que le passage à Redis ne nécessite pas de réécrire la moitié du code.
Comment distinguer un problème d'adresse d'un problème de site cible ?
Suivez les métriques par couple adresse-site, pas seulement par adresse. Si les erreurs sont concentrées sur une seule adresse pour tous les sites – c'est l'adresse le problème. Si elles concernent toutes les adresses pour un seul site – c'est le site le problème, et il ne faut pas punir les adresses. Si toutes les adresses pour tous les sites – cherchez le problème chez vous : réseau, infrastructure, le système de sondes lui-même. Cette découpe bidimensionnelle est le moyen le plus fiable de poser le bon diagnostic.
Que faire si presque tout le pool part en quarantaine ?
Cela devrait être impossible avec une protection correcte. Fixez une limite sur la proportion d'adresses en quarantaine simultanément. Garantissez un minimum d'adresses en service quelles que soient les circonstances. Apprenez au pool à reconnaître un échec massif et simultané comme un signe de problème général, pas de la faute des adresses. Lorsque la limite est atteinte, passez de la mise en quarantaine à une simple réduction de poids – mieux vaut travailler avec des ressources légèrement dégradées que de s'arrêter complètement.
Quelle stratégie de sélection par défaut adopter ?
Si vous n'avez pas de sessions et que les adresses sont homogènes – commencez par le round-robin. Si les adresses sont de qualité variable – sélection pondérée avec poids dynamique basé sur les métriques. Si les tâches ont des durées très différentes – least-connections. S'il y a une liaison avec des comptes ou des sessions – hachage cohérent par clé, et ce n'est pas négociable, car cela détermine la stabilité du travail avec les comptes. Dans les systèmes complexes, combinez les stratégies par type de tâche.
Faut-il compter les CAPTCHA séparément dans les métriques ?
Oui, absolument, et avec un seuil plus sensible que pour les erreurs ordinaires. Le CAPTCHA est un signal précoce et précis de baisse de réputation d'une adresse, souvent avant les refus directs. Si vous mélangez les CAPTCHA aux erreurs générales, vous perdrez cet indicateur avancé. Une métrique distincte du taux de CAPTCHA par adresse vous permettra de réduire le poids d'une adresse problématique avant même qu'elle ne commence à dysfonctionner ouvertement.
Comment éviter les locations bloquées quand un worker tombe ?
Ne comptez pas uniquement sur l'appel explicite à release. Créez la location comme un enregistrement avec un TTL légèrement supérieur à la durée maximale autorisée de la tâche. Si le worker tombe et ne rend pas l'adresse, l'enregistrement expirera de lui-même et le compteur de charge active se rétablira. Vous pouvez également vérifier périodiquement les compteurs par rapport à la réalité. Cela protège le pool d'une fuite lente de capacité due à des locations bloquées.
Conclusion et prochaines étapes
Nous avons parcouru un long chemin. De la réalité peu glorieuse de pourquoi une liste d'adresses dans un fichier texte se désagrège sous charge réelle, jusqu'à un système d'ingénierie complet de gestion d'adresses au sein de l'application. Résumons l'essentiel.
Un pool n'est pas une liste, mais un objet avec un comportement, caché derrière une interface simple acquire et release. La stratégie de sélection d'adresse est dictée par la tâche : round-robin pour les tâches homogènes, sélection pondérée pour les adresses de qualité variable, least-connections pour les tâches de durées différentes, et – crucial pour le travail avec les comptes – un hachage déterministe, de préférence cohérent, par clé. C'est la prévisibilité de l'environnement réseau, et non un hasard sophistiqué, qui donne la confiance des systèmes anti-fraude.
La santé des adresses repose sur deux jambes : le contrôle passif via le trafic réel et les sondes actives. L'échec est défini par un signal cumulé, pas une erreur unique, et le flapping est amorti par l'hystérésis et un temps de maintien minimal. La quarantaine repose sur un délai exponentiel avec jitter, limité par un plafond sur la proportion d'adresses exclues, et protégée contre la catastrophe où tout le pool risquerait d'être mis sur la touche. L'état, en présence de plusieurs workers, vit dans un stockage partagé avec des opérations atomiques et des TTL. Enfin, l'observabilité par couple adresse-site permet de distinguer une mauvaise adresse d'un mauvais site – une compétence qui fait gagner des semaines.
Que faire maintenant ? Je vous propose un plan d'implémentation concret par étapes.
- Enveloppez votre gestion actuelle des adresses dans l'interface acquire et release, sans rien changer à l'intérieur pour l'instant. Cela préparera le terrain.
- Ajoutez le health-check passif et une quarantaine simple en mémoire. Vous ressentirez déjà une amélioration de la stabilité.
- Introduisez la stratégie de sélection adaptée. Si vous travaillez avec des comptes, incorporez immédiatement le sticky via un hachage par clé.
- Connectez les sondes actives et le délai exponentiel avec les limites de protection.
- Déplacez l'état dans un stockage partagé dès l'apparition d'un deuxième worker. Prévoyez l'atomicité et les TTL.
- Configurez les métriques et les tableaux de bord, impérativement avec la découpe adresse-site.
- Affinez l'hystérésis et les seuils en fonction de vos données réelles – il n'y a pas de chiffres universels, seulement vos observations.
N'essayez pas de tout construire d'un coup. Laissez chaque couche mûrir sous charge, collectez des métriques, tirez des conclusions, avancez. Un pool de proxies mature n'est pas une construction unique, mais un système vivant que vous ajustez au fur et à mesure que vos besoins grandissent. Mais même les premières étapes de ce guide transformeront une liste fragile d'adresses en un socle fiable pour votre application. Et cela, avouez-le, en vaut la peine.